配置大模型提供方
把夜莺指向 OpenAI 兼容、Anthropic 或自托管模型:密钥、地址与模型选择。
这页办完你会得到:一条「测试连接」通过、处于启用状态、并且带着默认标签的 LLM 配置—— 产品里所有 AI 能力都以它为前提。
页面在哪
Nightingale AI → LLM 管理,地址 /nightingale-ai/llm-configs。它没有顶级菜单入口;
老地址 /ai-config/llm-configs 会跳到这里。
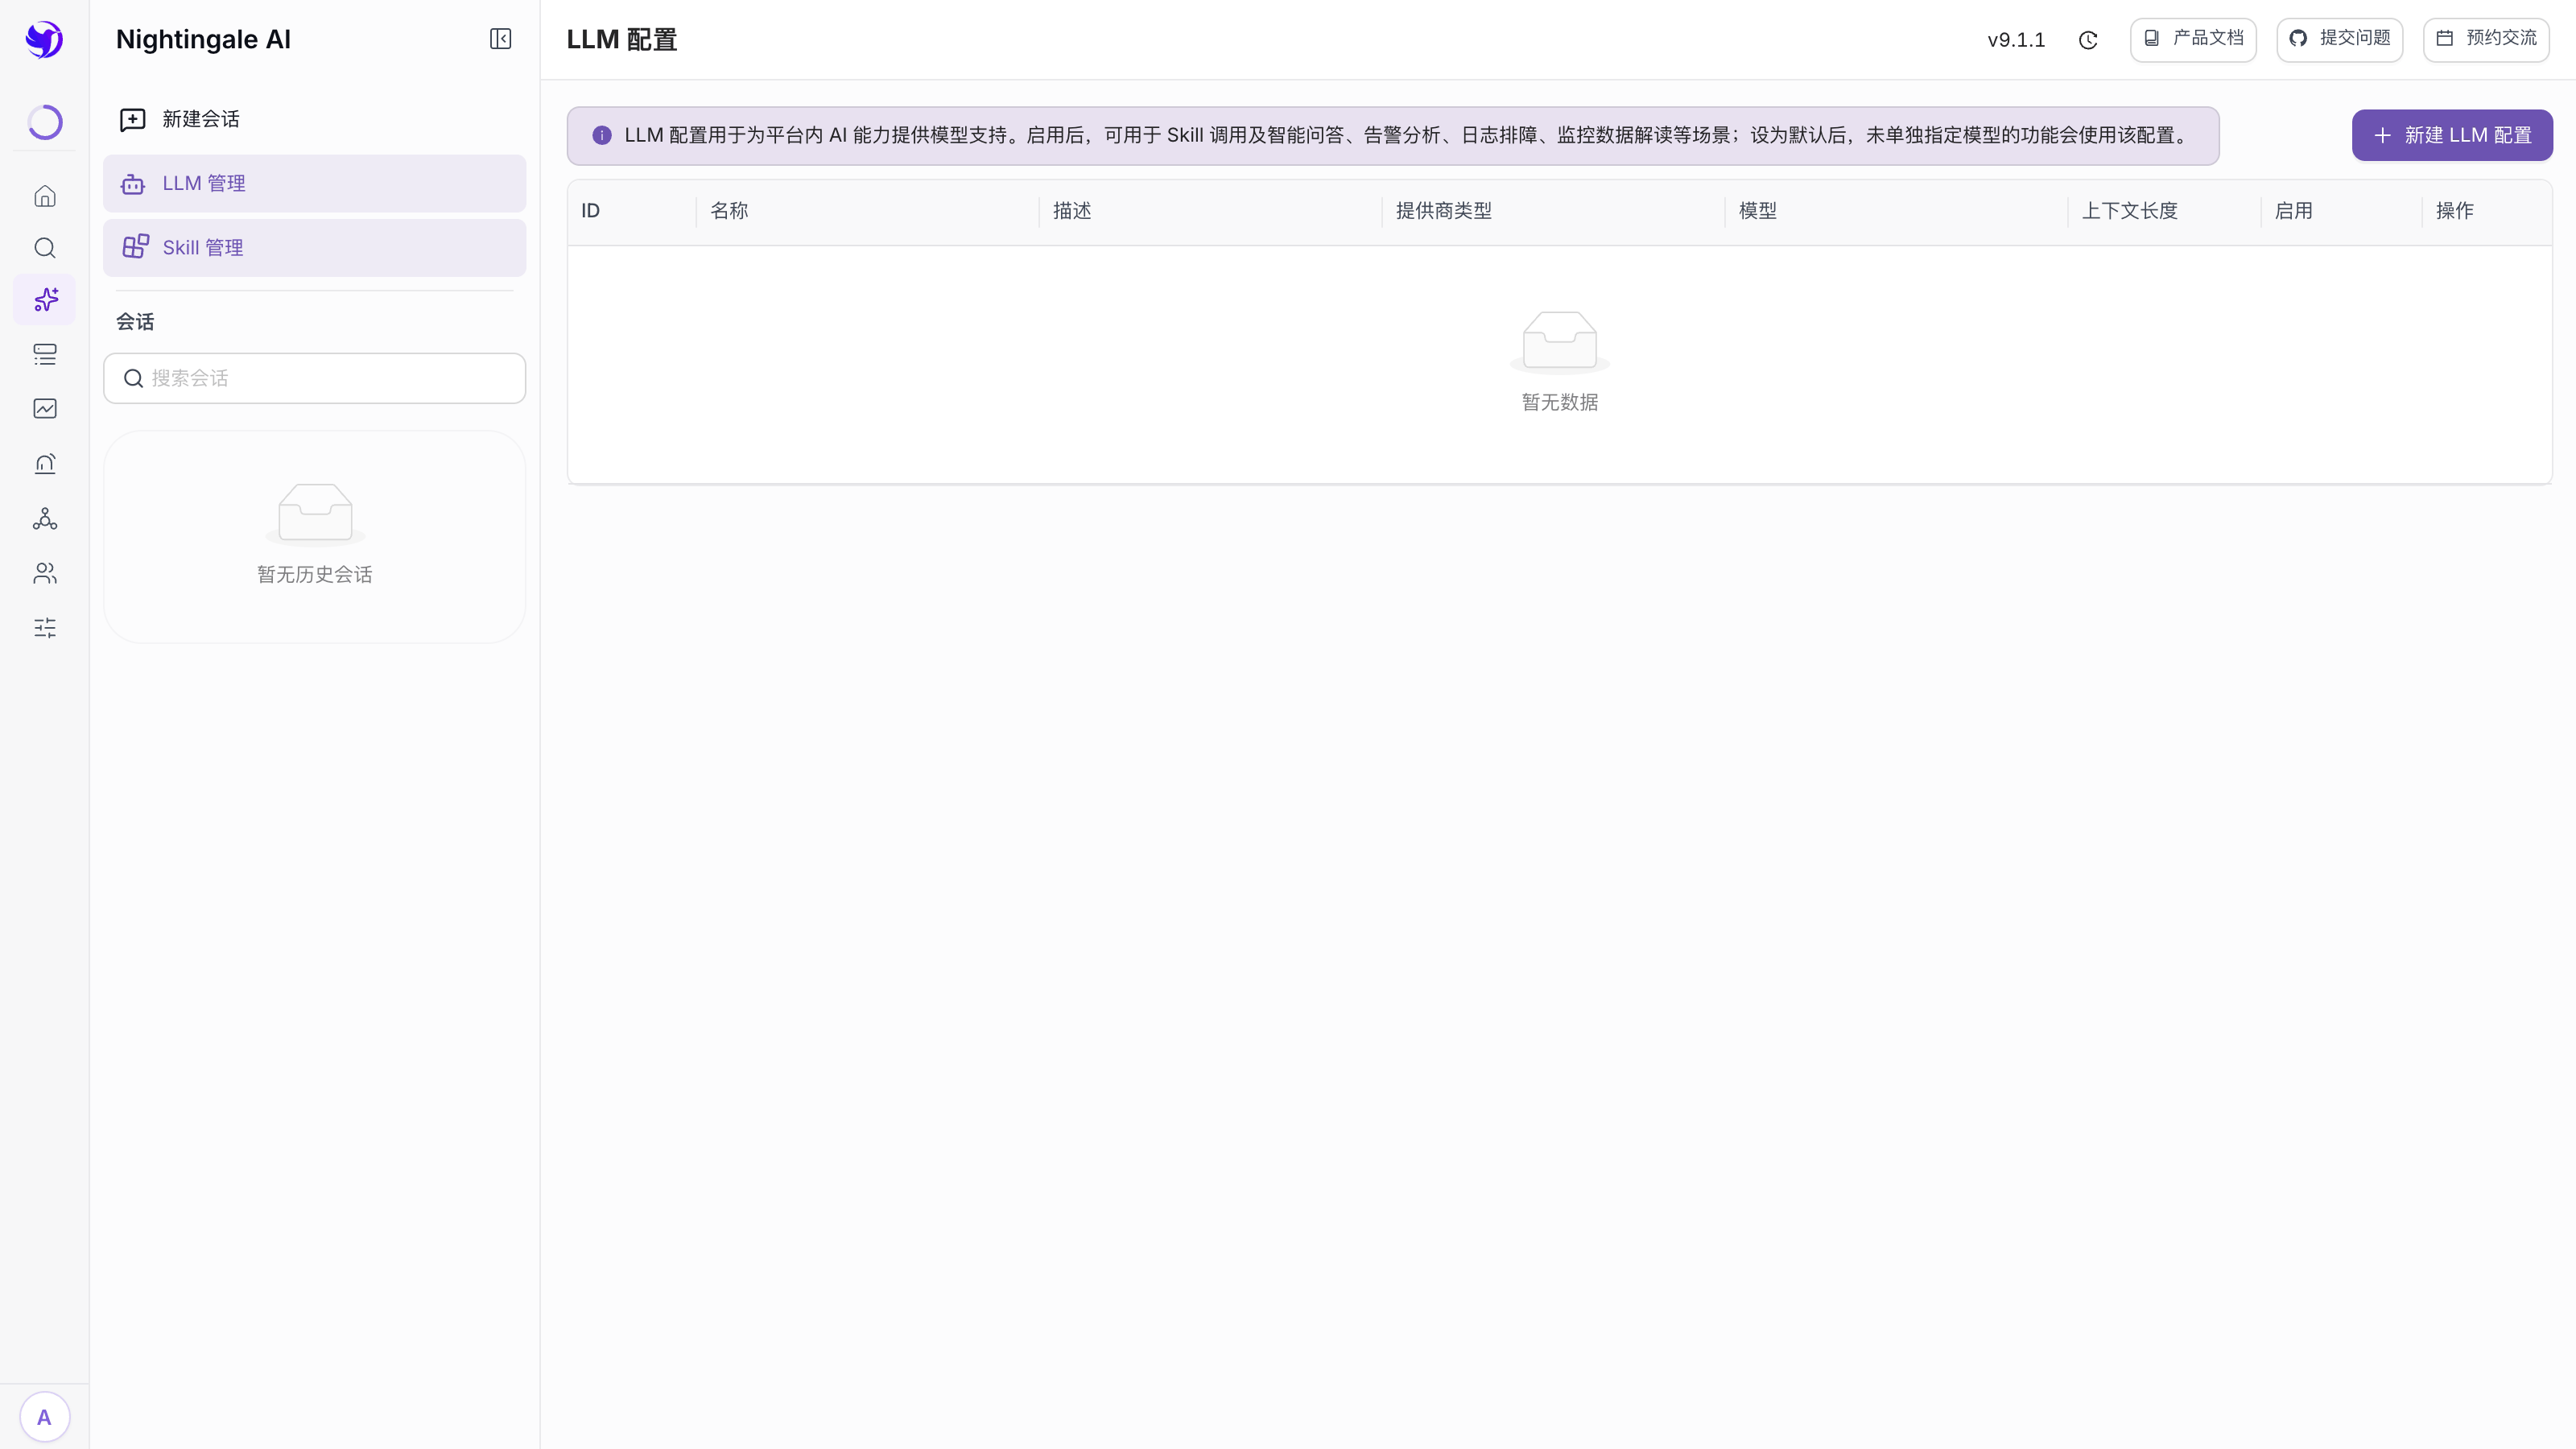
页面由权限点 /ai-config/llm-configs 把守,Standard 和 Guest 都不带这个点。
也就是说:要么用 Admin,要么在人员组织 → 角色管理里建一个带这个点的自定义角色。
模型相关的东西在 etc/config.toml 里一个字都没有——一条配置就是一行数据库记录,
新增或修改下一次提问就生效,不用重启。
三种提供商类型
| 提供商类型 | 协议 | 用来接什么 |
|---|---|---|
| OpenAI 兼容 | OpenAI Chat Completions | OpenAI、Azure OpenAI、DeepSeek、通义 DashScope 兼容模式、火山方舟、智谱 GLM、Kimi,以及自建的 vLLM、Ollama |
| Anthropic Claude | Anthropic Messages | Claude 官方,以及重新实现了这套接口的网关 |
| Google Gemini | Gemini generateContent | Google AI Studio |
只要对方提供 /v1/chat/completions,就走「OpenAI 兼容」,自己部署的模型也一样。
夜莺没有自己的模型服务:你在这里填的地址,就是监控数据唯一会去的地方——
用局域网里的 Ollama 或 vLLM,数据就完全不出域。
填表
点新建 LLM 配置,五个必填项:
| 字段 | 说明 |
|---|---|
| 名称 | 自己起。写成 提供商-模型 在列表里最好认,比如 openai-gpt-4o |
| 提供商类型 | 上面三种之一,默认 OpenAI 兼容 |
| 模型 | 模型 ID,原样传给提供商,所以拼写必须和对方完全一致。Azure 要填部署名,火山方舟要填 endpoint id |
| API URL | 填版本根路径,不是对话路径——见下 |
| API Key | 保存后掩码显示:列表和编辑表单里看到的是 sk-a****wxyz 这种形态 |
旁边还有两个开关——启用(默认开)和默认(默认关,下面单说)——以及一个随便写的描述。
API URL 填什么
填到版本根这一级,剩下的夜莺自己补:
| 服务 | API URL |
|---|---|
| OpenAI | https://api.openai.com/v1 |
| DeepSeek | https://api.deepseek.com |
| 通义 DashScope 兼容模式 | https://dashscope.aliyuncs.com/compatible-mode/v1 |
| 同机的 Ollama | http://localhost:11434/v1 |
| Anthropic | https://api.anthropic.com |
| Google Gemini | https://generativelanguage.googleapis.com |
| Azure OpenAI | https://RESOURCE.openai.azure.com/openai/deployments/DEPLOYMENT |
已经以 /chat/completions 结尾的地址(Claude 是 /v1/messages)会原样使用,
所以填完整端点也行。Azure 还需要 api-version,写进下面的自定义参数里。
即使对方不校验,API Key 也必须填。 Ollama 随便填个非空字符串就行。
高级设置
全是可选项,而且只作用于这一条配置,不影响整个实例:
| 字段 | 什么时候要动 |
|---|---|
| 超时时间(秒) | 模型慢或者上下文很大。留空时对话允许 120 秒 |
| 跳过 TLS 验证 | 局域网里的自签名网关。公网端点绝对不要开 |
| 代理地址 | http://proxy.example.com:8080,夜莺所在机器出不了公网时填 |
| 自定义请求头 | 网关除了 Key 还要一个额外的头 |
| 自定义参数(JSON) | 合并进请求体:{"top_p": 0.9}、Azure 的 api-version,或者某家关闭思考模式的开关。必须是合法 JSON,否则表单不让保存 |
| 随机程度(Temperature) | 0~2。告警分析要往小了调 |
| 最大 Tokens | 单次回复的长度上限 |
| 上下文长度 | 模型的窗口大小(Token 数)。夜莺按这个数决定一次带多少历史对话;留空则固定按 96 KiB 算 |
Gemini 只认自定义参数里的 thinking_config,其余键忽略;另外两类是整个对象合并进请求体。
先测连接再保存
抽屉底部是取消 / 测试连接 / 保存。测试会拿表单里的内容——包括你还没保存的 Key—— 向那个地址真发一次一句话的提问,然后回报结果。
预期结果:弹出连接成功,带一个毫秒数的往返耗时。失败弹窗会说清是哪一类: 鉴权、端点不存在、被限流,或者回了个空内容。先修好再保存: 一条只在提问时才暴露问题的配置,排查起来麻烦得多。
设为默认
默认决定了所有没单独绑定模型的地方用哪一个——对话、Skill,以及告警规则、仪表盘、 通知模板表单上的那些 AI 按钮。你创建的第一条配置会自动成为默认; 之后给某一条打开默认开关,会在同一个事务里把其它条的默认关掉,所以永远只有一条。
预期结果:那一行的名称后面出现一个紫色的默认标签。
列表
列是 ID、名称、描述、提供商类型、模型、上下文长度、启用、操作。
- 启用是就地拨动的开关;关掉的配置任何地方都不会用;
- 配置处于启用状态时,删除按钮是灰的——先把开关关掉。创建人是
system的行则完全删不掉; - 改配置不用重新输 Key:把掩码那串留着不动,存的还是原来的 Key。
验证
打开 Nightingale AI → 新建会话,先问一句不需要数据的:
你能做什么?
预期结果:流式吐出一段回答。如果看到的是一张写着当前环境没有大模型配置的卡片, 说明没有任何一条配置同时是「启用 + 默认」——回去把两个开关都确认一遍。
然后再问一句需要你的数据的,把工具调用那一半也验证掉:
现在有哪些活跃告警?
下一步
- 助手拿这个模型做什么:Nightingale AI 概览
- 把团队的方法教给它:安装、管理与编写 Skills
- 它报错的时候:AI / Skill / MCP 排障