ClickHouse / Doris / IoTDB
ClickHouse、Doris、IoTDB 同属 SQL 类数据源:查询结果的数值列成为序列值,其余列成为标签,直接用于告警判定。
这三个存的东西不一样——ClickHouse 和 Doris 通常放海量日志和明细, IoTDB 放设备时序——但在夜莺里它们是同一类:用 SQL 查,查出来的表被当成序列去判定告警。 这页讲怎么接、SQL 要写成什么形态、以及结果的哪一列变成数值、哪一列变成标签。
三者在开源版里能做什么
它们的能力边界不一样,动手之前先看清楚,免得接完发现在探索器里选不到:
| 注册数据源 | 告警规则 | 即时查询 | 仪表盘 | |
|---|---|---|---|---|
| ClickHouse | ✓ | ✓ | — | — |
| Doris | ✓ | ✓ | — | — |
| IoTDB | ✓ | ✓ | ✓ | ✓ |
也就是说,ClickHouse 和 Doris 在开源版里的唯一落点是告警规则。 它们不会出现在数据查询的数据源下拉框里,也选不进仪表盘面板。 IoTDB 没有这个限制。
三者都能配告警规则,但前提是先注册出至少一个该类型的数据源—— 告警规则表单里的「数据源类型」只列出你已经注册过的类型,一个 Doris 数据源都没有的话, 这个类型的卡片根本不出现。
ClickHouse
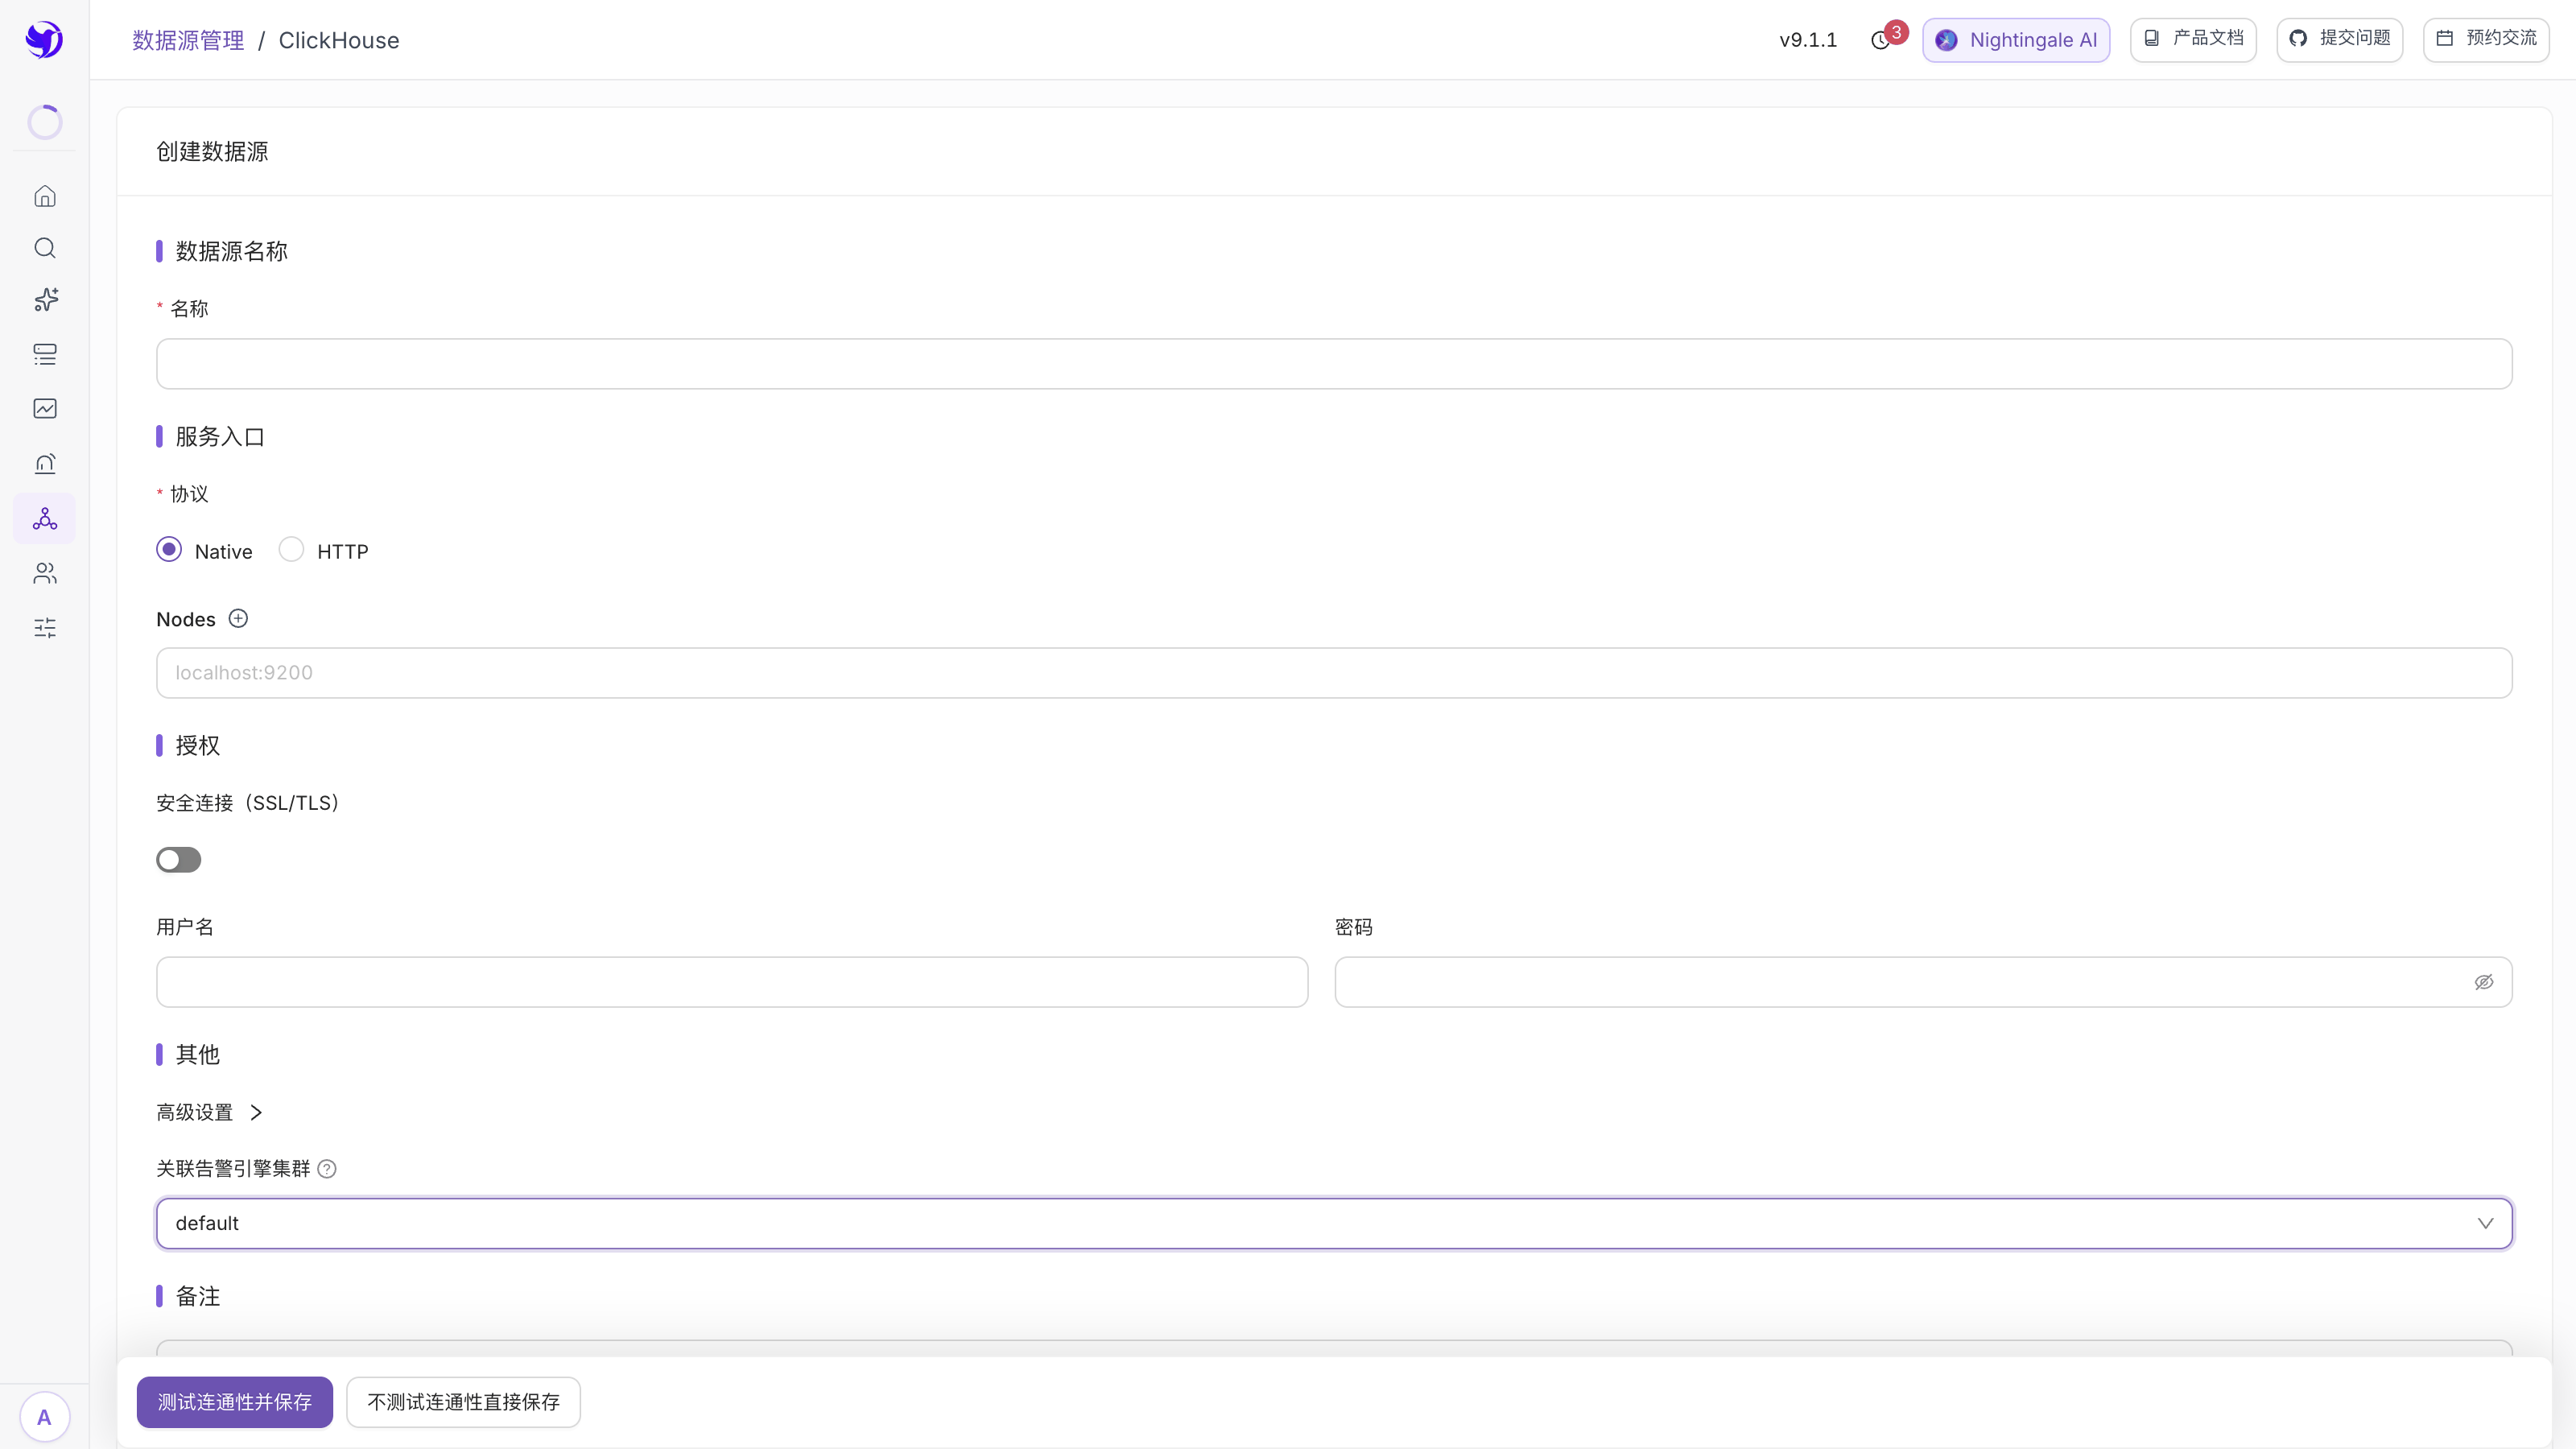
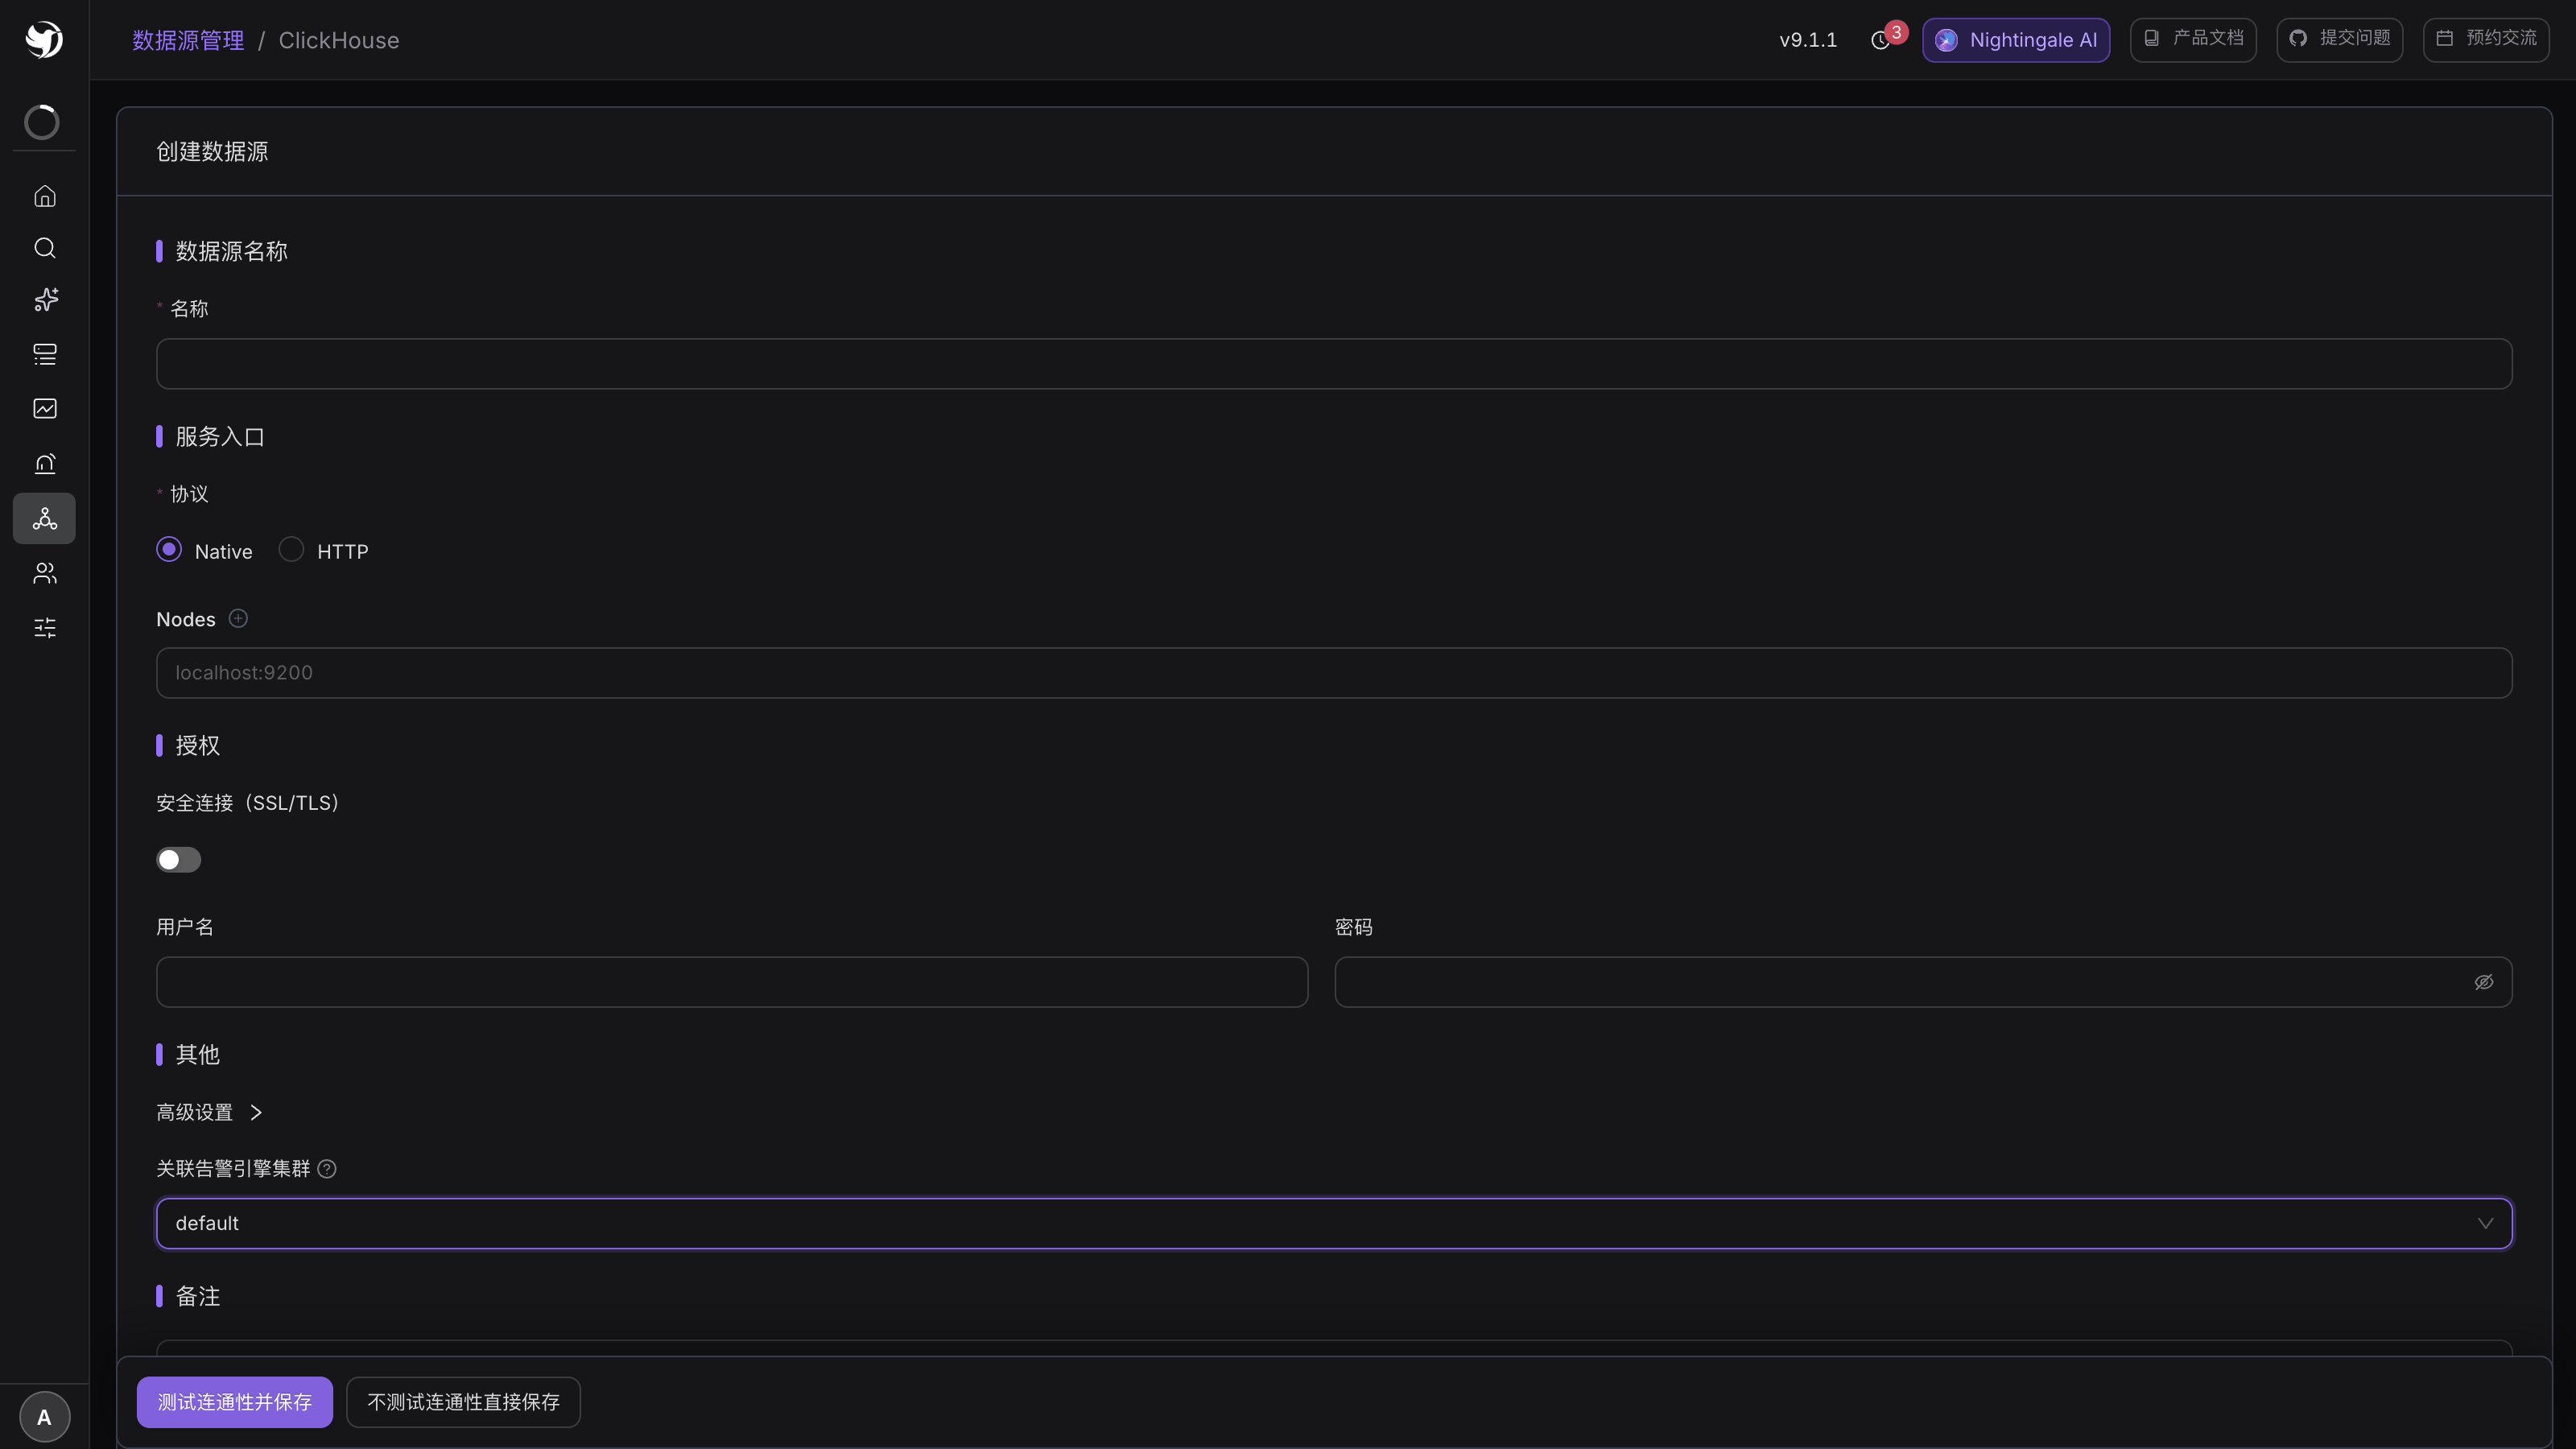
集成中心 → 数据源 → 新增 → ClickHouse。
| 字段 | 填什么 |
|---|---|
| 名称 | 必填 |
| 协议 | Native 或 HTTP,默认 Native |
| Nodes | host:port,不能带 http:// 前缀,带了会被直接挡下来。Native 默认端口 9000,HTTP 默认端口 8123(表单里的占位符写的是 9200,那是笔误,别照抄) |
| 安全连接(SSL/TLS) | 开启后会多出一个「跳过 SSL 验证」开关 |
| 用户名 / 密码 | 按需 |
Nodes 是个可以加行的列表,但当前实现只用第一个节点,多填的暂时不会参与轮询。
「高级设置」里是连接池和限流:超时时间(毫秒,默认 100000)、 单次请求允许检索的最大行数(默认 500,必填)、最大空闲连接数(10)、 最大打开连接数(100)、连接最大生存时间(秒,14400)。
点 测试连通性并保存 时,夜莺会真的建连接并执行一次 SHOW DATABASES,
过不了就不入库。地址格式写错(带了 http://)属于配置错误,用「不测试连通性直接保存」
也存不进去。
Doris
集成中心 → 数据源 → 新增 → Doris。
| 字段 | 填什么 |
|---|---|
| 名称 | 必填 |
| URL | FE 的 MySQL 协议地址,localhost:9030 这种写法,不带 scheme |
| 用户名 / 密码 | 按需 |
| 超时时间(单位: 毫秒) | 默认 100000 |
| 单次请求允许检索的最大行数 | 默认 500 |
| 最大空闲 / 打开连接数、连接最大生存时间 | 同 ClickHouse |
Doris 的查询编辑器里有数据库和数据表两个下拉框,选完之后可以用「快捷查询」 按模板生成 SQL,也可以切「自定义查询」自己写。
它还有一个时间宏:$__timeFilter(\timestamp`)`。SQL 里写了它,
页面上选的时间区间才会作用到查询上;没写的话编辑器会弹一条警告
——「查询条件中未包含时间宏,所选的时间区间将不会生效」,
意思是这条 SQL 可能在扫全表。
IoTDB
集成中心 → 数据源 → 新增 → IoTDB。
| 字段 | 填什么 |
|---|---|
| 名称 | 必填 |
| URL | REST 接口地址,表单里已经预填了 http://localhost:18080 |
| 超时(单位:ms) | 默认 10000 |
| 用户名 / 密码 | 按需 |
保存时的连通性测试是往 <URL>/rest/table/v1/query 发一条 show databases。
IoTDB 的查询编辑器多两个东西:查询模板(一组现成的 SQL,把里面的 $变量
换成实际值就能用)和时间字段 / 时间格式——因为 IoTDB 的时间列名字不固定,
要显式告诉夜莺哪一列是时间轴、按什么格式解析。
查询结果怎么变成序列
这是 SQL 类数据源和 PromQL 类数据源最大的差别,也是最容易卡住的地方。
PromQL 返回的本来就是时序;SQL 返回的是一张表。夜莺靠两个「辅助配置」把表翻译成序列:
- 值字段:结果里哪些列是数值,参与阈值判定、画成曲线。必填;
- 标签字段:结果里哪些列作为序列的标签,通常就是
GROUP BY的那几列。可选。
举个最简单的:
SELECT count(*) AS err_count
FROM logs.app_log
WHERE level = 'ERROR'
  AND event_time > now() - INTERVAL 5 MINUTE
值字段选 err_count,告警条件写 $A.err_count > 1000。
想让每个服务单独告警,就 GROUP BY 之后把分组列设成标签字段:
SELECT service, count(*) AS err_count
FROM logs.app_log
WHERE level = 'ERROR'
  AND event_time > now() - INTERVAL 5 MINUTE
GROUP BY service
值字段 err_count,标签字段 service。SQL 返回几行,就有几条独立序列,
告警引擎逐行判定——十行就最多十条事件,每条事件的标签里带着自己那个 service。
这也意味着一条没有 GROUP BY 又返回几千行的 SQL,会一次性烧出几千条事件。
写完 SQL 一定先点 数据预览,确认返回的列名和行数符合预期,再去配阈值。
别让告警查询扫全表
告警规则里的 SQL 是周期性执行的,执行频率填 60 秒就是每分钟扫一次。三条纪律:
- WHERE 里一定要限定时间范围,并且用分区列或主键列,
比如
event_time > now() - INTERVAL 5 MINUTE。Doris 用$__timeFilter()时间宏; - 执行频率和查询代价匹配。一条要扫十秒的 SQL 别配成 15 秒一次;
- 限制返回行数。数据源表单里那个「单次请求允许检索的最大行数」就是最后一道闸, 默认 500,不要为了图省事调到几万。
下一步
- SQL 类规则怎么写:SQL 类告警规则
- 阈值表达式的语法:告警规则
- 对业务库直接告警:MySQL / PostgreSQL / TDengine