MySQL / PostgreSQL / TDengine
直接对业务数据库告警:只读账号、规则执行的 SQL、以及怎么防慢查询。
有些指标压根不在时序库里:待处理订单数、支付失败率、某张表最后一条记录的时间。 这类东西没必要先 export 成指标再采集,夜莺可以直接连上业务库, 周期性跑一条 SQL,对结果判定告警。
这页办完你会得到:一个只读账号、一个接好的数据库数据源, 以及一条能跑起来的、不会拖垮业务库的 SQL 告警规则。
开源版里各自能做什么
同一页里三种数据库,能力边界不一样:
| 注册数据源 | 告警规则 | 即时查询 | 仪表盘 | |
|---|---|---|---|---|
| MySQL | ✓ | ✓ | — | — |
| PostgreSQL | ✓ | ✓ | — | — |
| TDengine | ✓ | ✓ | ✓ | ✓ |
MySQL 和 PostgreSQL 在开源版里的落点是告警规则,探索器和仪表盘选不到它们。 验证一条 SQL 写得对不对,用告警规则表单里的「数据预览」按钮,那是开源版唯一能跑 业务库 SQL 的地方。TDengine 没有这个限制。
先建一个只读账号
别拿 root 接。夜莺连业务库这件事,权限最小化的收益很直接: 配置写错、凭据泄露、SQL 写飞,损失面都被账号权限挡住。
-- MySQL
CREATE USER 'n9e_readonly'@'%' IDENTIFIED BY '<password>';
GRANT SELECT ON business_db.* TO 'n9e_readonly'@'%';
FLUSH PRIVILEGES;
-- PostgreSQL
CREATE ROLE n9e_readonly LOGIN PASSWORD '<password>';
GRANT CONNECT ON DATABASE business_db TO n9e_readonly;
GRANT USAGE ON SCHEMA public TO n9e_readonly;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO n9e_readonly;
只 GRANT SELECT,只授到需要查的那个库。账号的来源 IP 也限一下——
'n9e_readonly'@'10.0.0.%' 比 @'%' 好。
注册数据源
集成中心 → 数据源 → 新增,选 MySQL、PostgreSQL 或 TDengine。
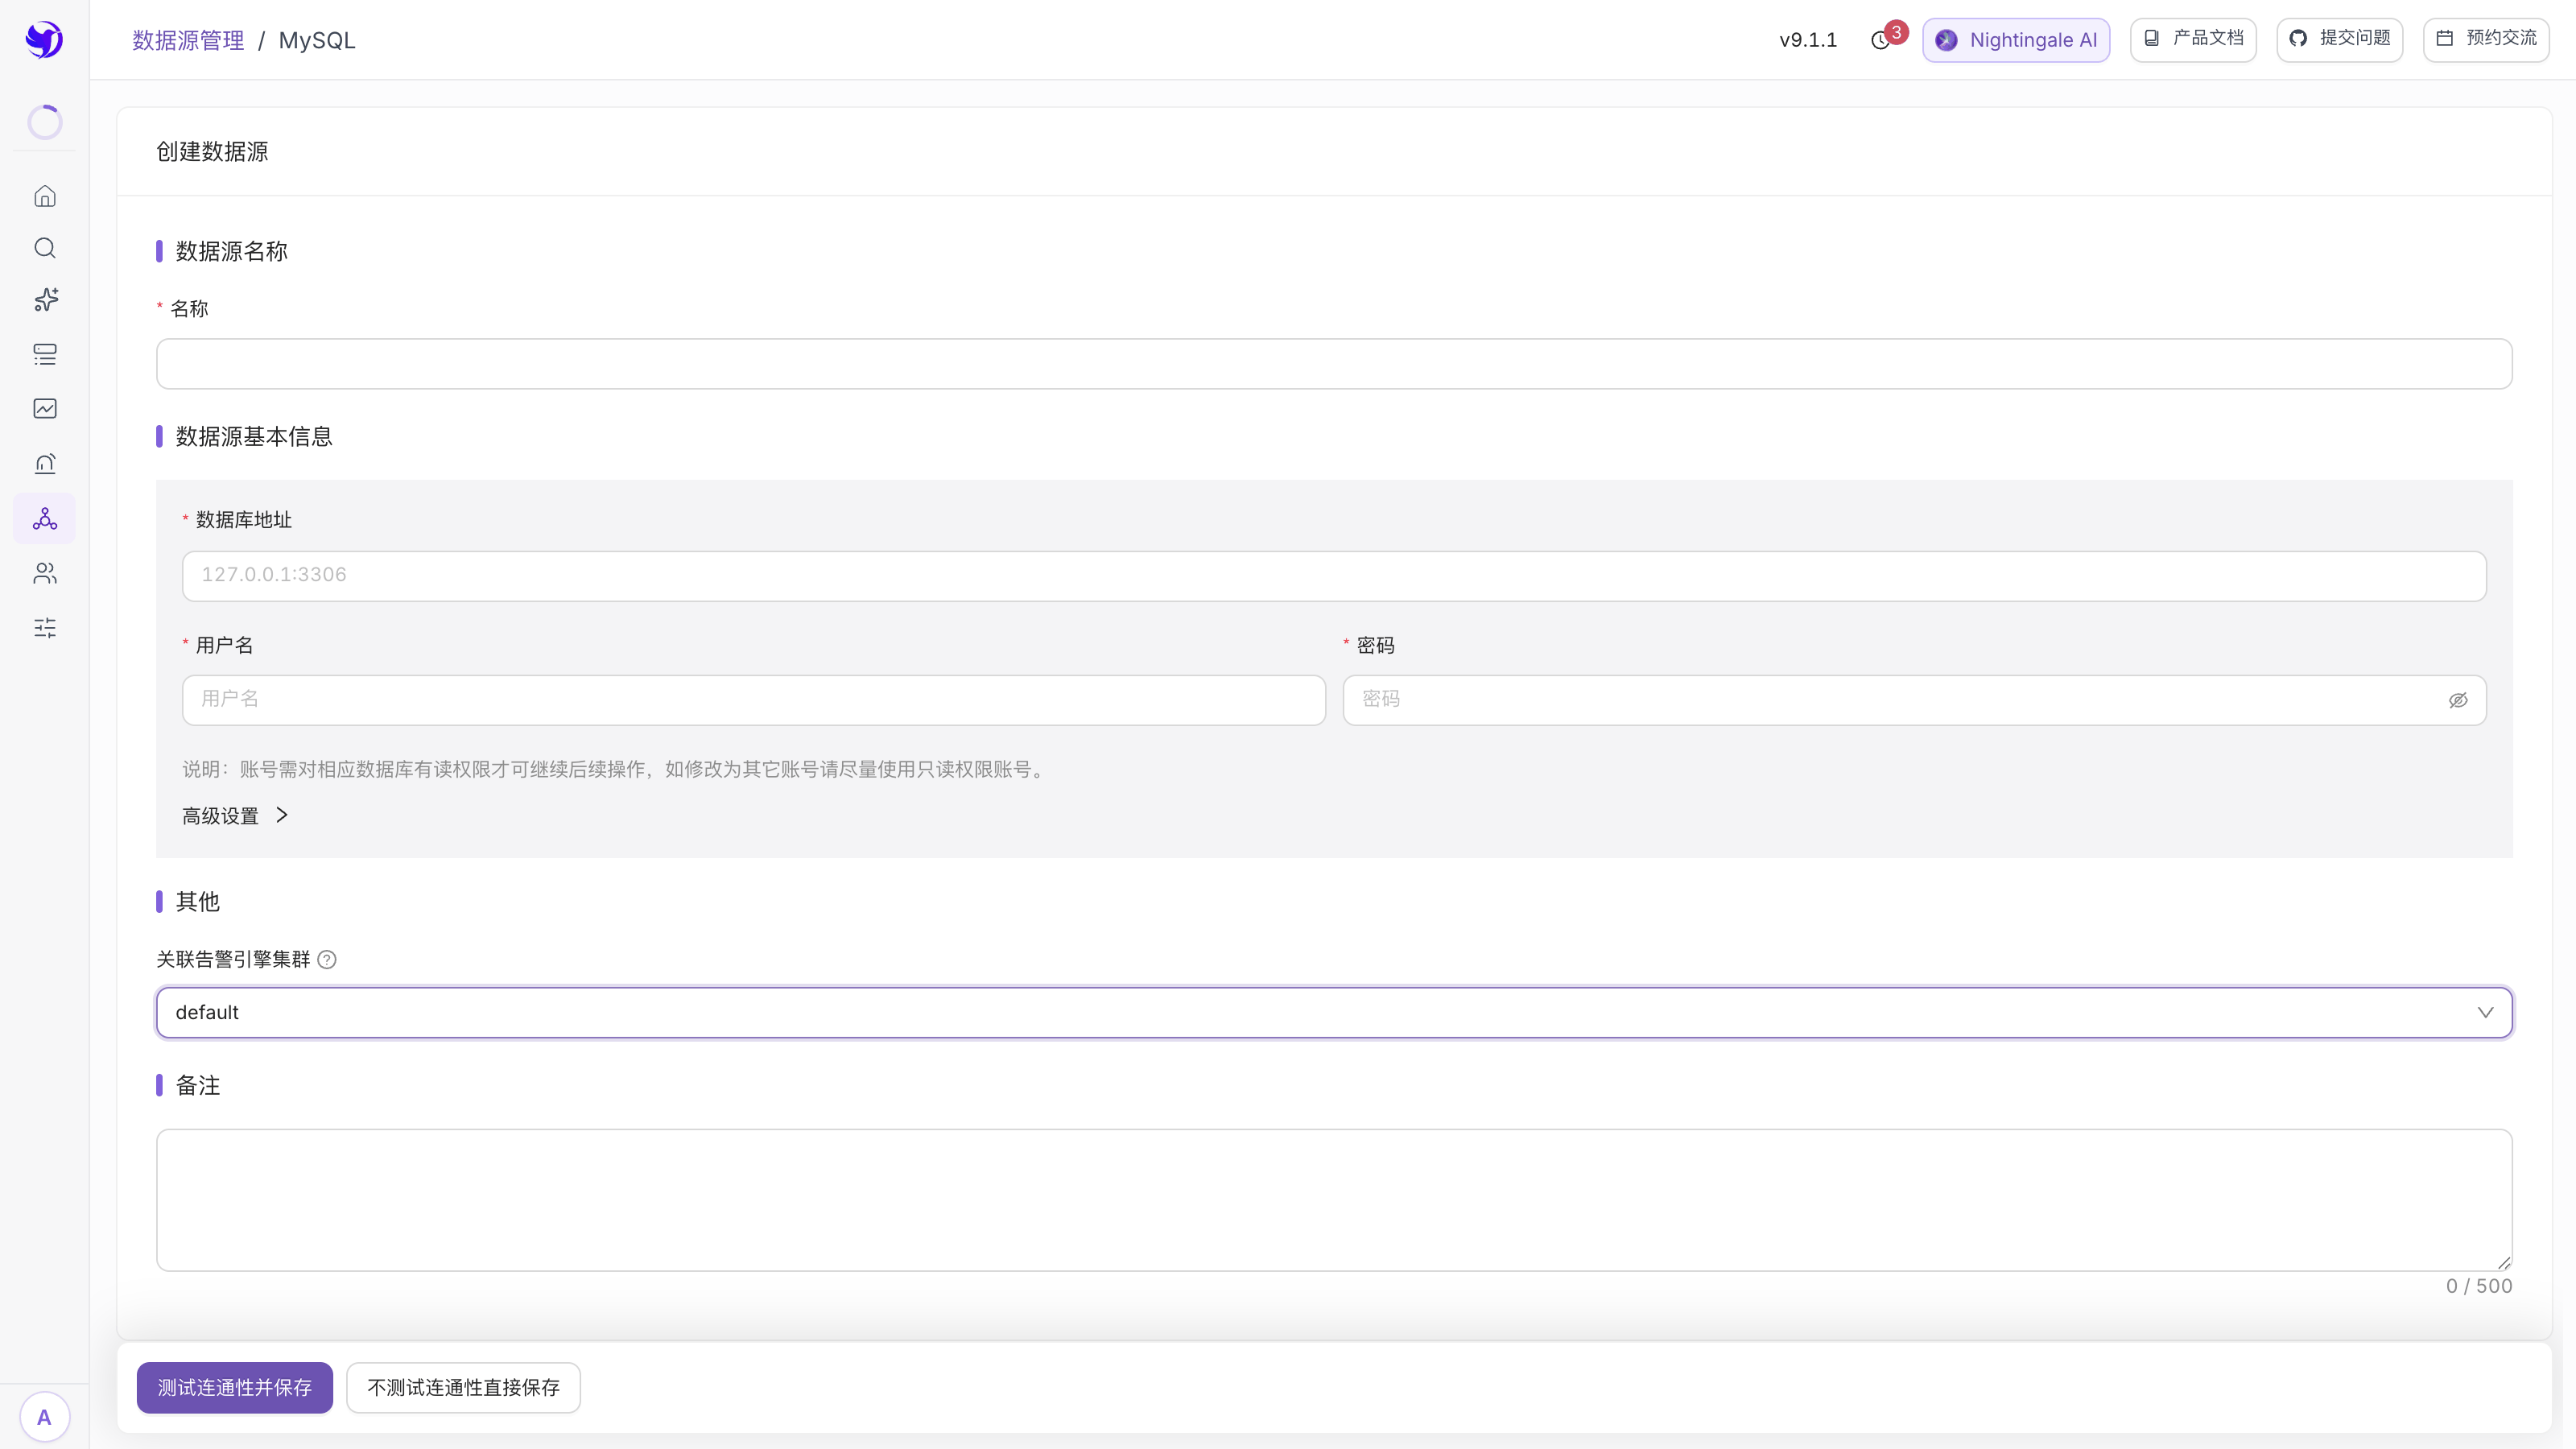
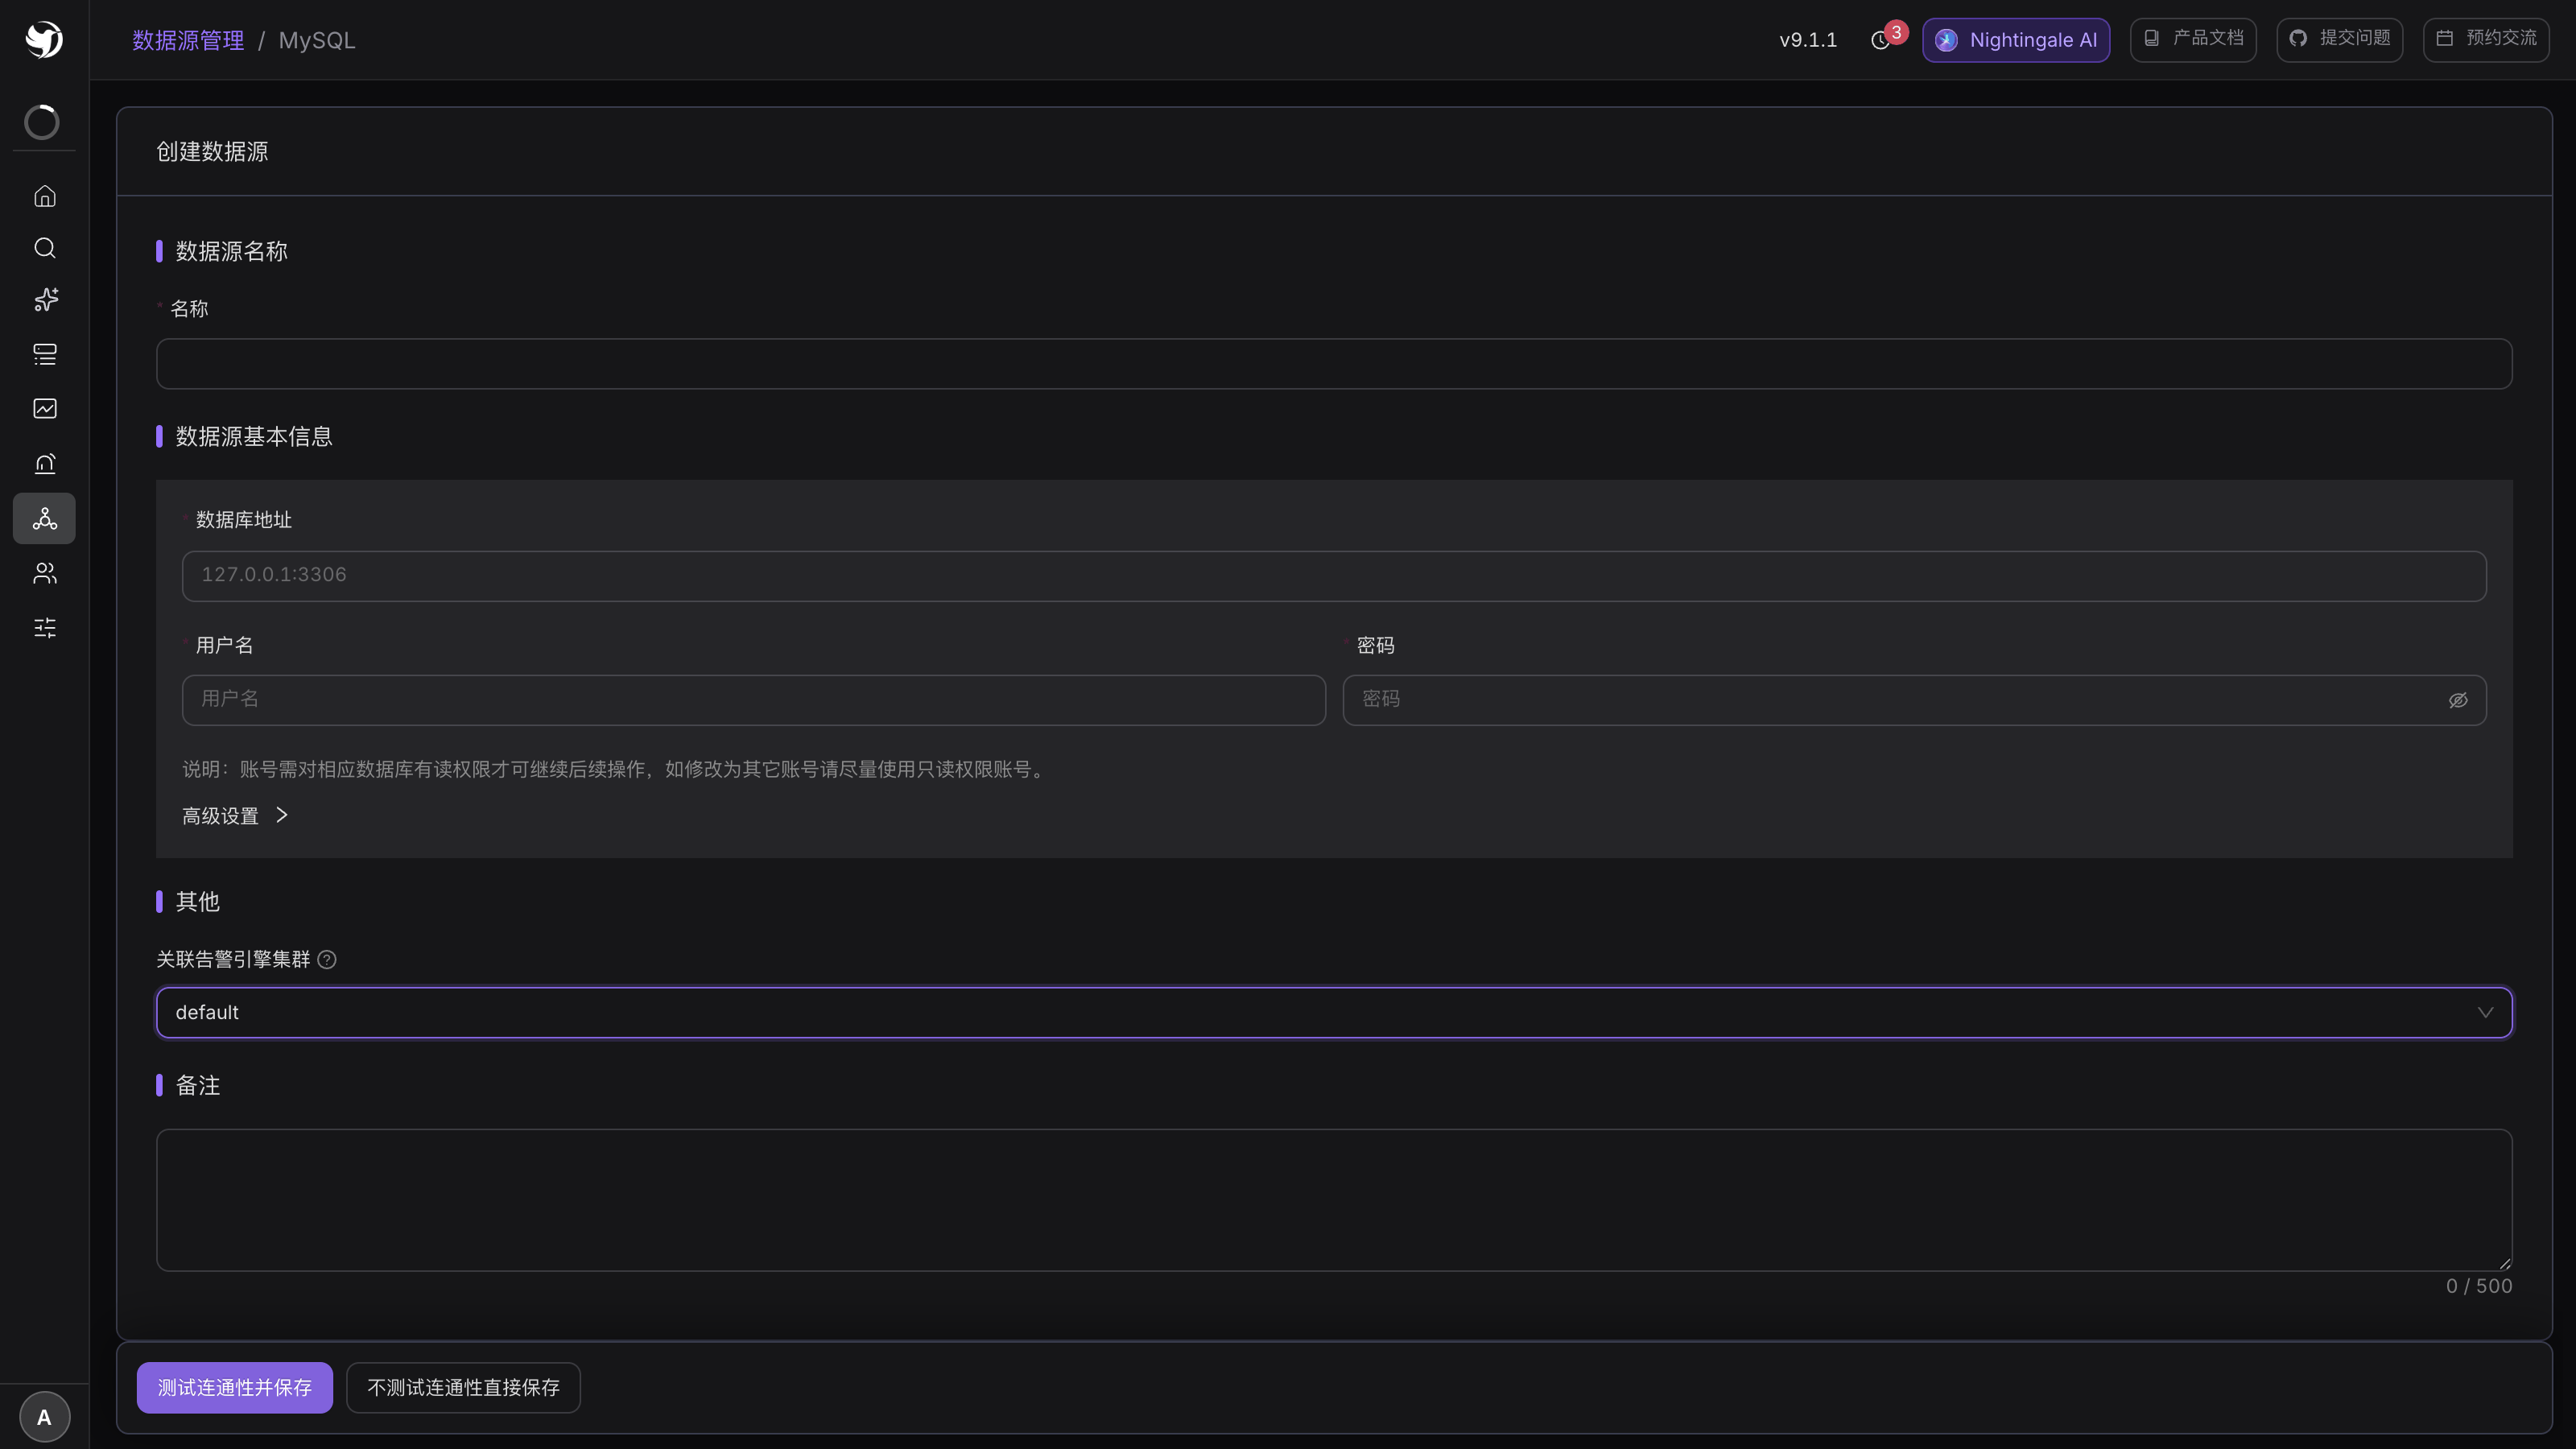
MySQL 和 PostgreSQL 的表单一样,只是默认端口不同:
| 字段 | 说明 |
|---|---|
| 数据库地址 | 必填。127.0.0.1:3306(MySQL)/ 127.0.0.1:5432(PostgreSQL),不带 scheme |
| 用户名 / 密码 | 都是必填,填上一步建的只读账号 |
| 超时时间(单位: 秒) | 默认 60 |
| 单次请求允许检索的最大行数 | 默认 500,必填 |
| 最大空闲连接数 / 最大打开连接数 | 默认 10 / 100。业务库连接数紧张就往下调 |
| 连接最大生存时间(单位: 秒) | 默认 14400 |
TDengine 走的是 REST 接口,字段少一些:URL 填 http://localhost:6041,
超时单位是毫秒(默认 10000),用户名密码按需。保存时的连通性测试是往
<URL>/rest/sql 发一条 show databases。
三者都要确认 关联告警引擎集群 不为空,留空的话这个数据源上的规则不会被评估。
规则执行的 SQL 长什么样
告警通知 → 规则管理 → 新增,数据源类型选 MySQL / PostgreSQL / TDengine, 再选中具体的数据源。查询部分就是一条 SQL——它扮演的角色和指标规则里的 PromQL 一样。
SQL 要满足两个条件:返回的行数可控,至少有一列是数值。
-- 待处理订单堆积
SELECT count(*) AS pending
FROM orders
WHERE status = 'PENDING'
  AND created_at > NOW() - INTERVAL 10 MINUTE
-- 每个渠道各自算失败率
SELECT channel,
       sum(CASE WHEN status = 'FAIL' THEN 1 ELSE 0 END) AS failed,
       count(*) AS total
FROM payments
WHERE created_at > NOW() - INTERVAL 5 MINUTE
GROUP BY channel
-- 数据新鲜度:最后一条记录距今多少秒
SELECT TIMESTAMPDIFF(SECOND, MAX(updated_at), NOW()) AS lag_seconds
FROM sync_state
TDengine 的编辑器还多了查询模板、以及时间字段 / 时间格式—— 指定哪一列作为时间轴、按什么格式解析。
结果的哪一列是数值
SQL 返回的是一张表,夜莺靠两个「辅助配置」把它翻成序列:
- 值字段(必填):哪些列是数值,参与阈值判定;
- 标签字段(可选):哪些列作为标签,通常就是
GROUP BY的列。
上面第二个例子里,值字段选 failed 和 total,标签字段选 channel,
告警条件就可以写成:
$A.failed / $A.total * 100 > 5
SQL 返回几行,就有几条独立序列,逐行判定。 按 channel 分了三组,
就最多出三条事件,每条事件的标签里带着自己的 channel。
写完点 数据预览,确认列名和行数对得上,再配阈值。
防慢查询
这条 SQL 会按执行频率反复跑在你的生产库上,写之前先想清楚代价:
- WHERE 里必须有时间范围,并且落在有索引的列上。
created_at > NOW() - INTERVAL 5 MINUTE这类写法,比全表 count 便宜几个数量级; - 执行频率和查询代价匹配。 一条要跑 3 秒的 SQL 别配 15 秒一次; 业务库的查询建议从 60 秒起步;
- 别
SELECT *。 只取参与判定的那几列; - 让「单次请求允许检索的最大行数」当兜底。 默认 500,不要随手调到几万—— 它拦的是「一条 SQL 意外返回百万行」这种事故;
- 超时别配太长。 MySQL / PostgreSQL 的超时单位是秒,默认 60; 配成几百秒相当于放弃了这道保护。
如果这条查询确实很贵,正确的做法不是调参,而是在库那边建一张预聚合表 (物化视图 / 定时任务),让夜莺查那张表。
下一步
- SQL 类规则的完整写法:SQL 类告警规则
- 让事件送到人:通知
- 日志明细类存储:ClickHouse / Doris / IoTDB