活跃事件与历史事件
活跃事件列表放着尚未恢复的告警,恢复后转入历史事件;两张表都能按标签、级别、业务组检索并批量处置。
这页办完你会知道:一条告警现在在哪张表里、为什么在那里,以及值班时怎么从几百条里 快速捞出你要的那几条。
入口:告警通知 → 告警事件,页面顶部两个 tab——活跃告警 和 历史告警。
两张列表的区别
活跃告警 /alert-cur-events | 历史告警 /alert-his-events | |
|---|---|---|
| 装什么 | 当前仍在告警、还没恢复的事件 | 所有产生过的事件,含已恢复的 |
| 一条事件待多久 | 恢复的那一刻消失 | 永久保留,直到你清理 |
| 时间筛选默认值 | 不限(几十天前就在烧的也在) | 最近 6 小时 |
| 能做的事 | 屏蔽、删除、分享 | 检索、导出、清理 |
事件恢复时,活跃告警里的那条消失,历史告警里多出一条状态为 Recovered 的记录——
不是同一行搬过去,两张表本来就各存各的。
事件的身份:规则 + 标签集
一条规则跑在 5 台机器上,会产生 5 个独立事件,因为它们的标签集不同(ident 不一样)。
每个事件各自触发、各自恢复、各自通知。列表里看到「同一条规则名出现 5 行」是正常的,
不是重复。
事件的业务组取自规则所属的业务组,不是机器所属的业务组。用「我的业务组 / 全部业务组」 筛不到某条事件时,先确认规则挂在哪个业务组下。
找到你要的那条
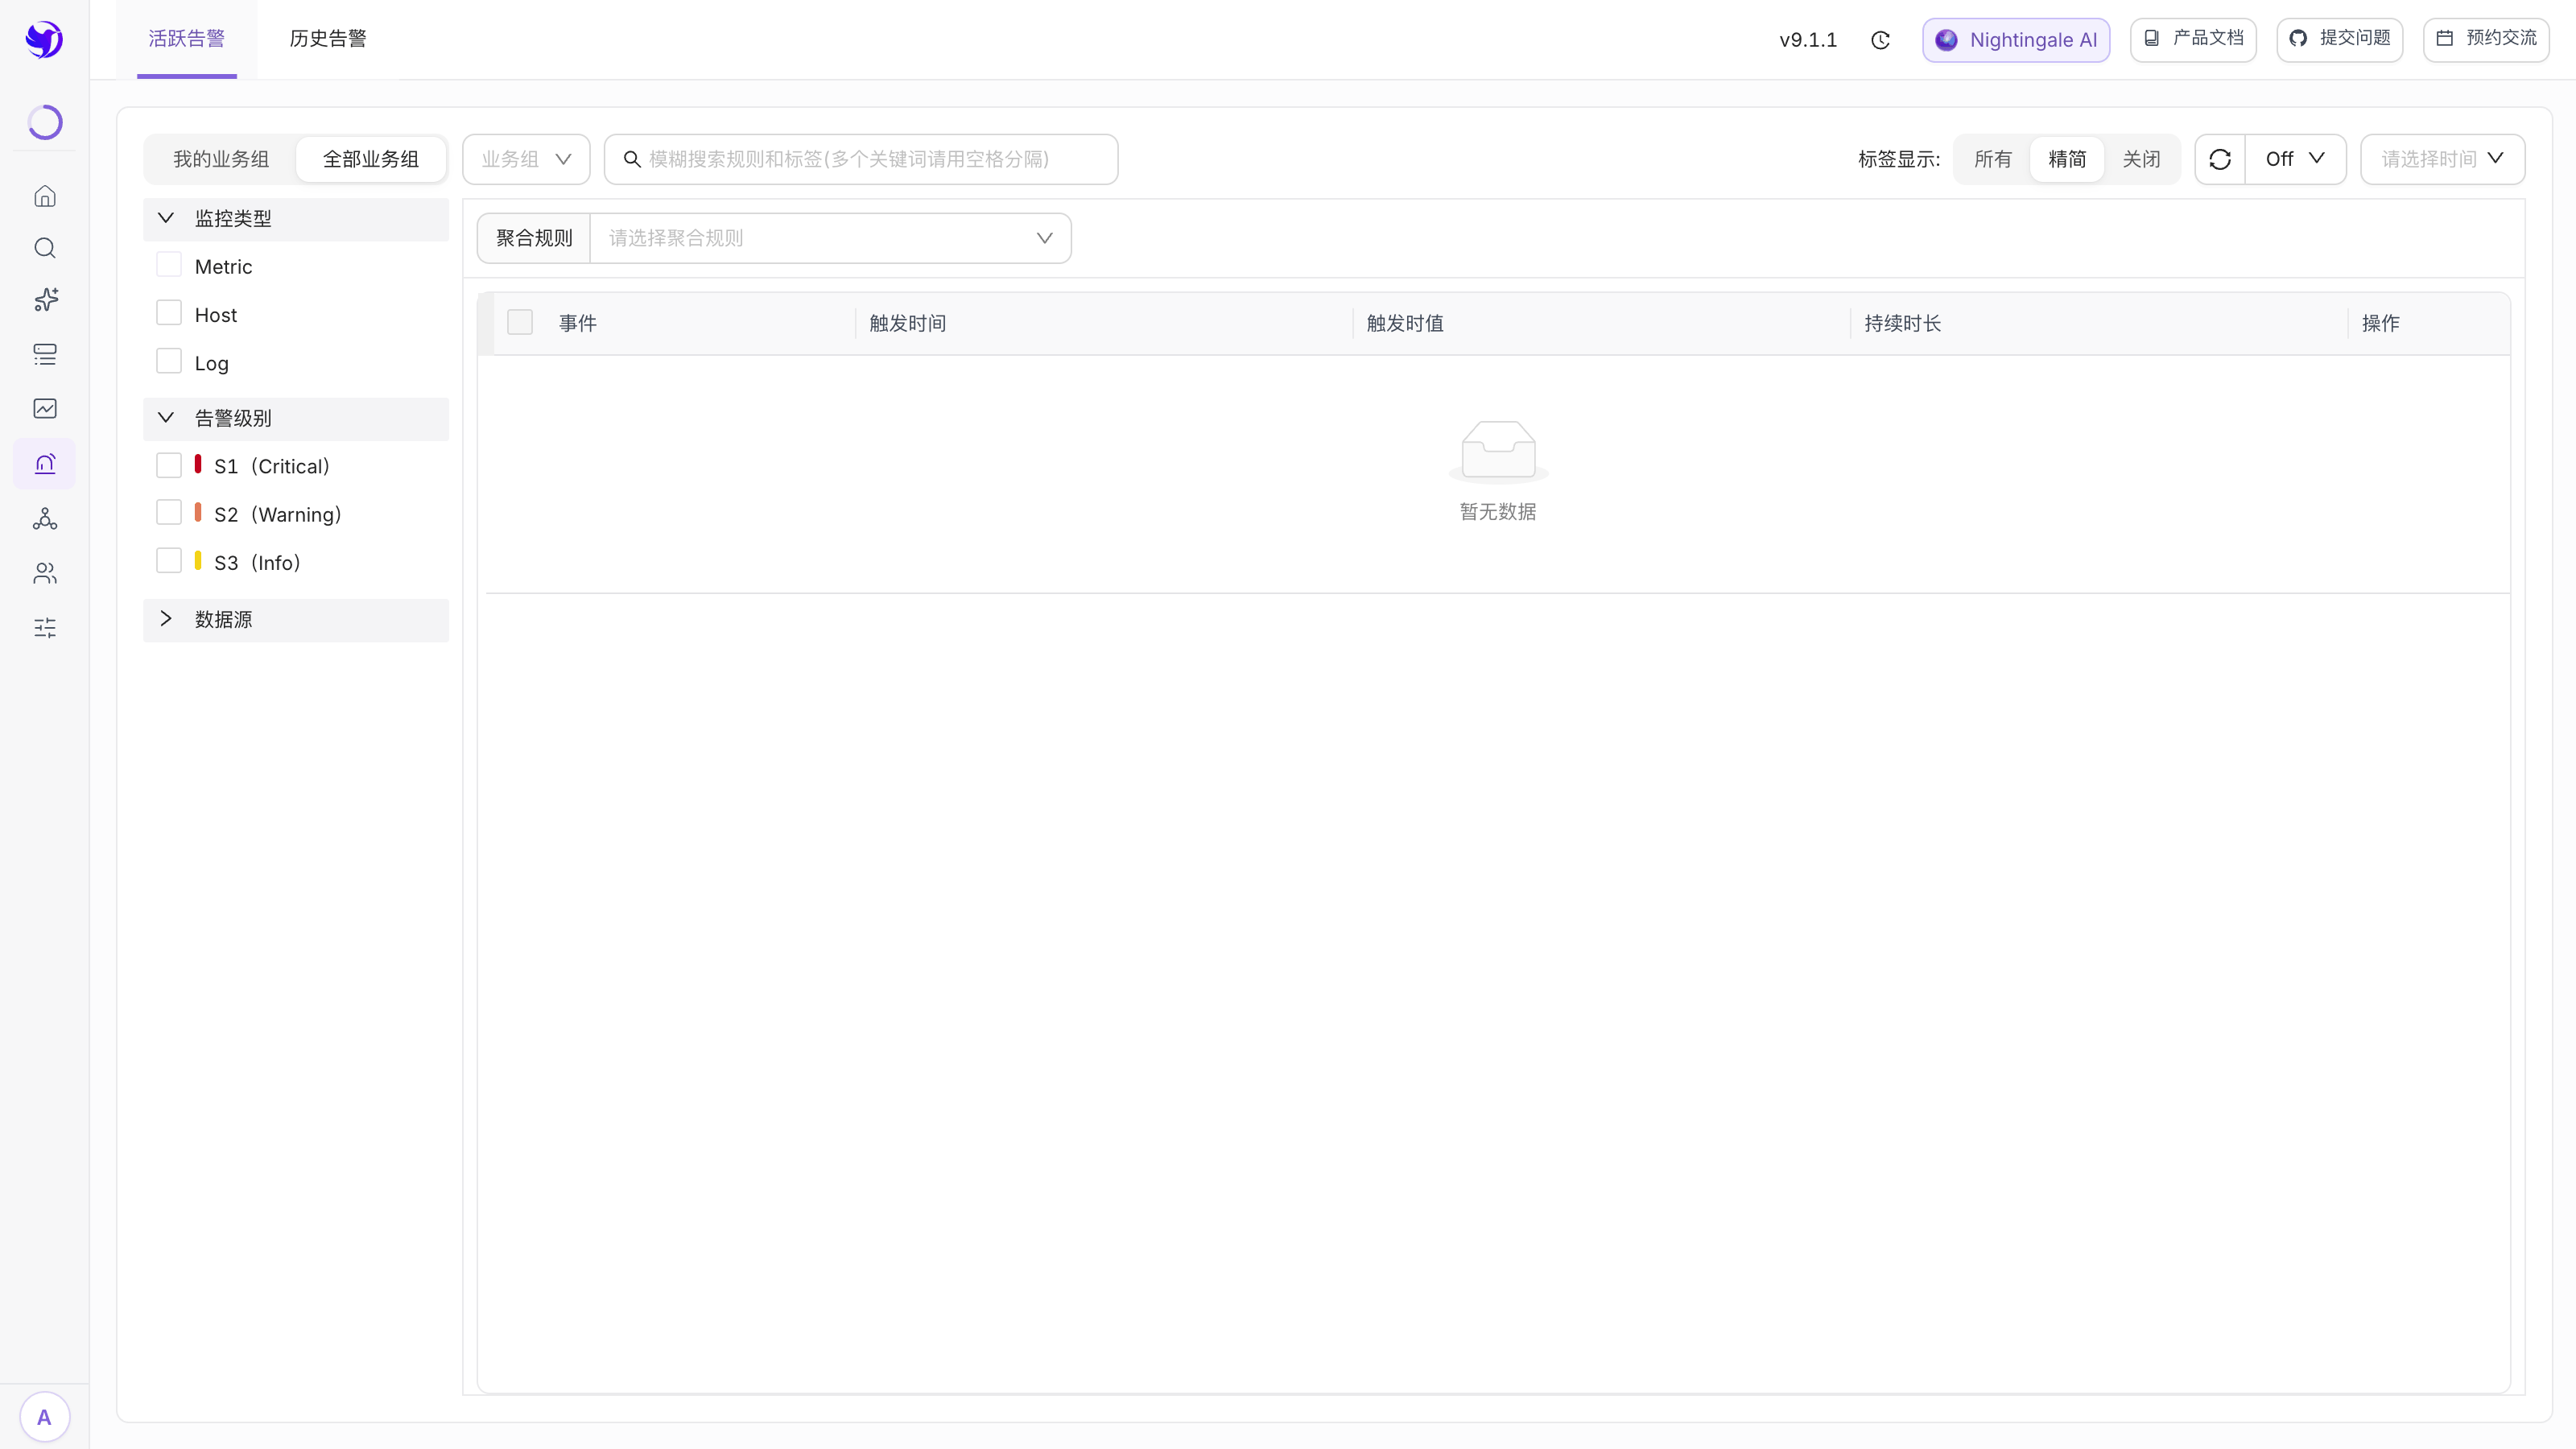
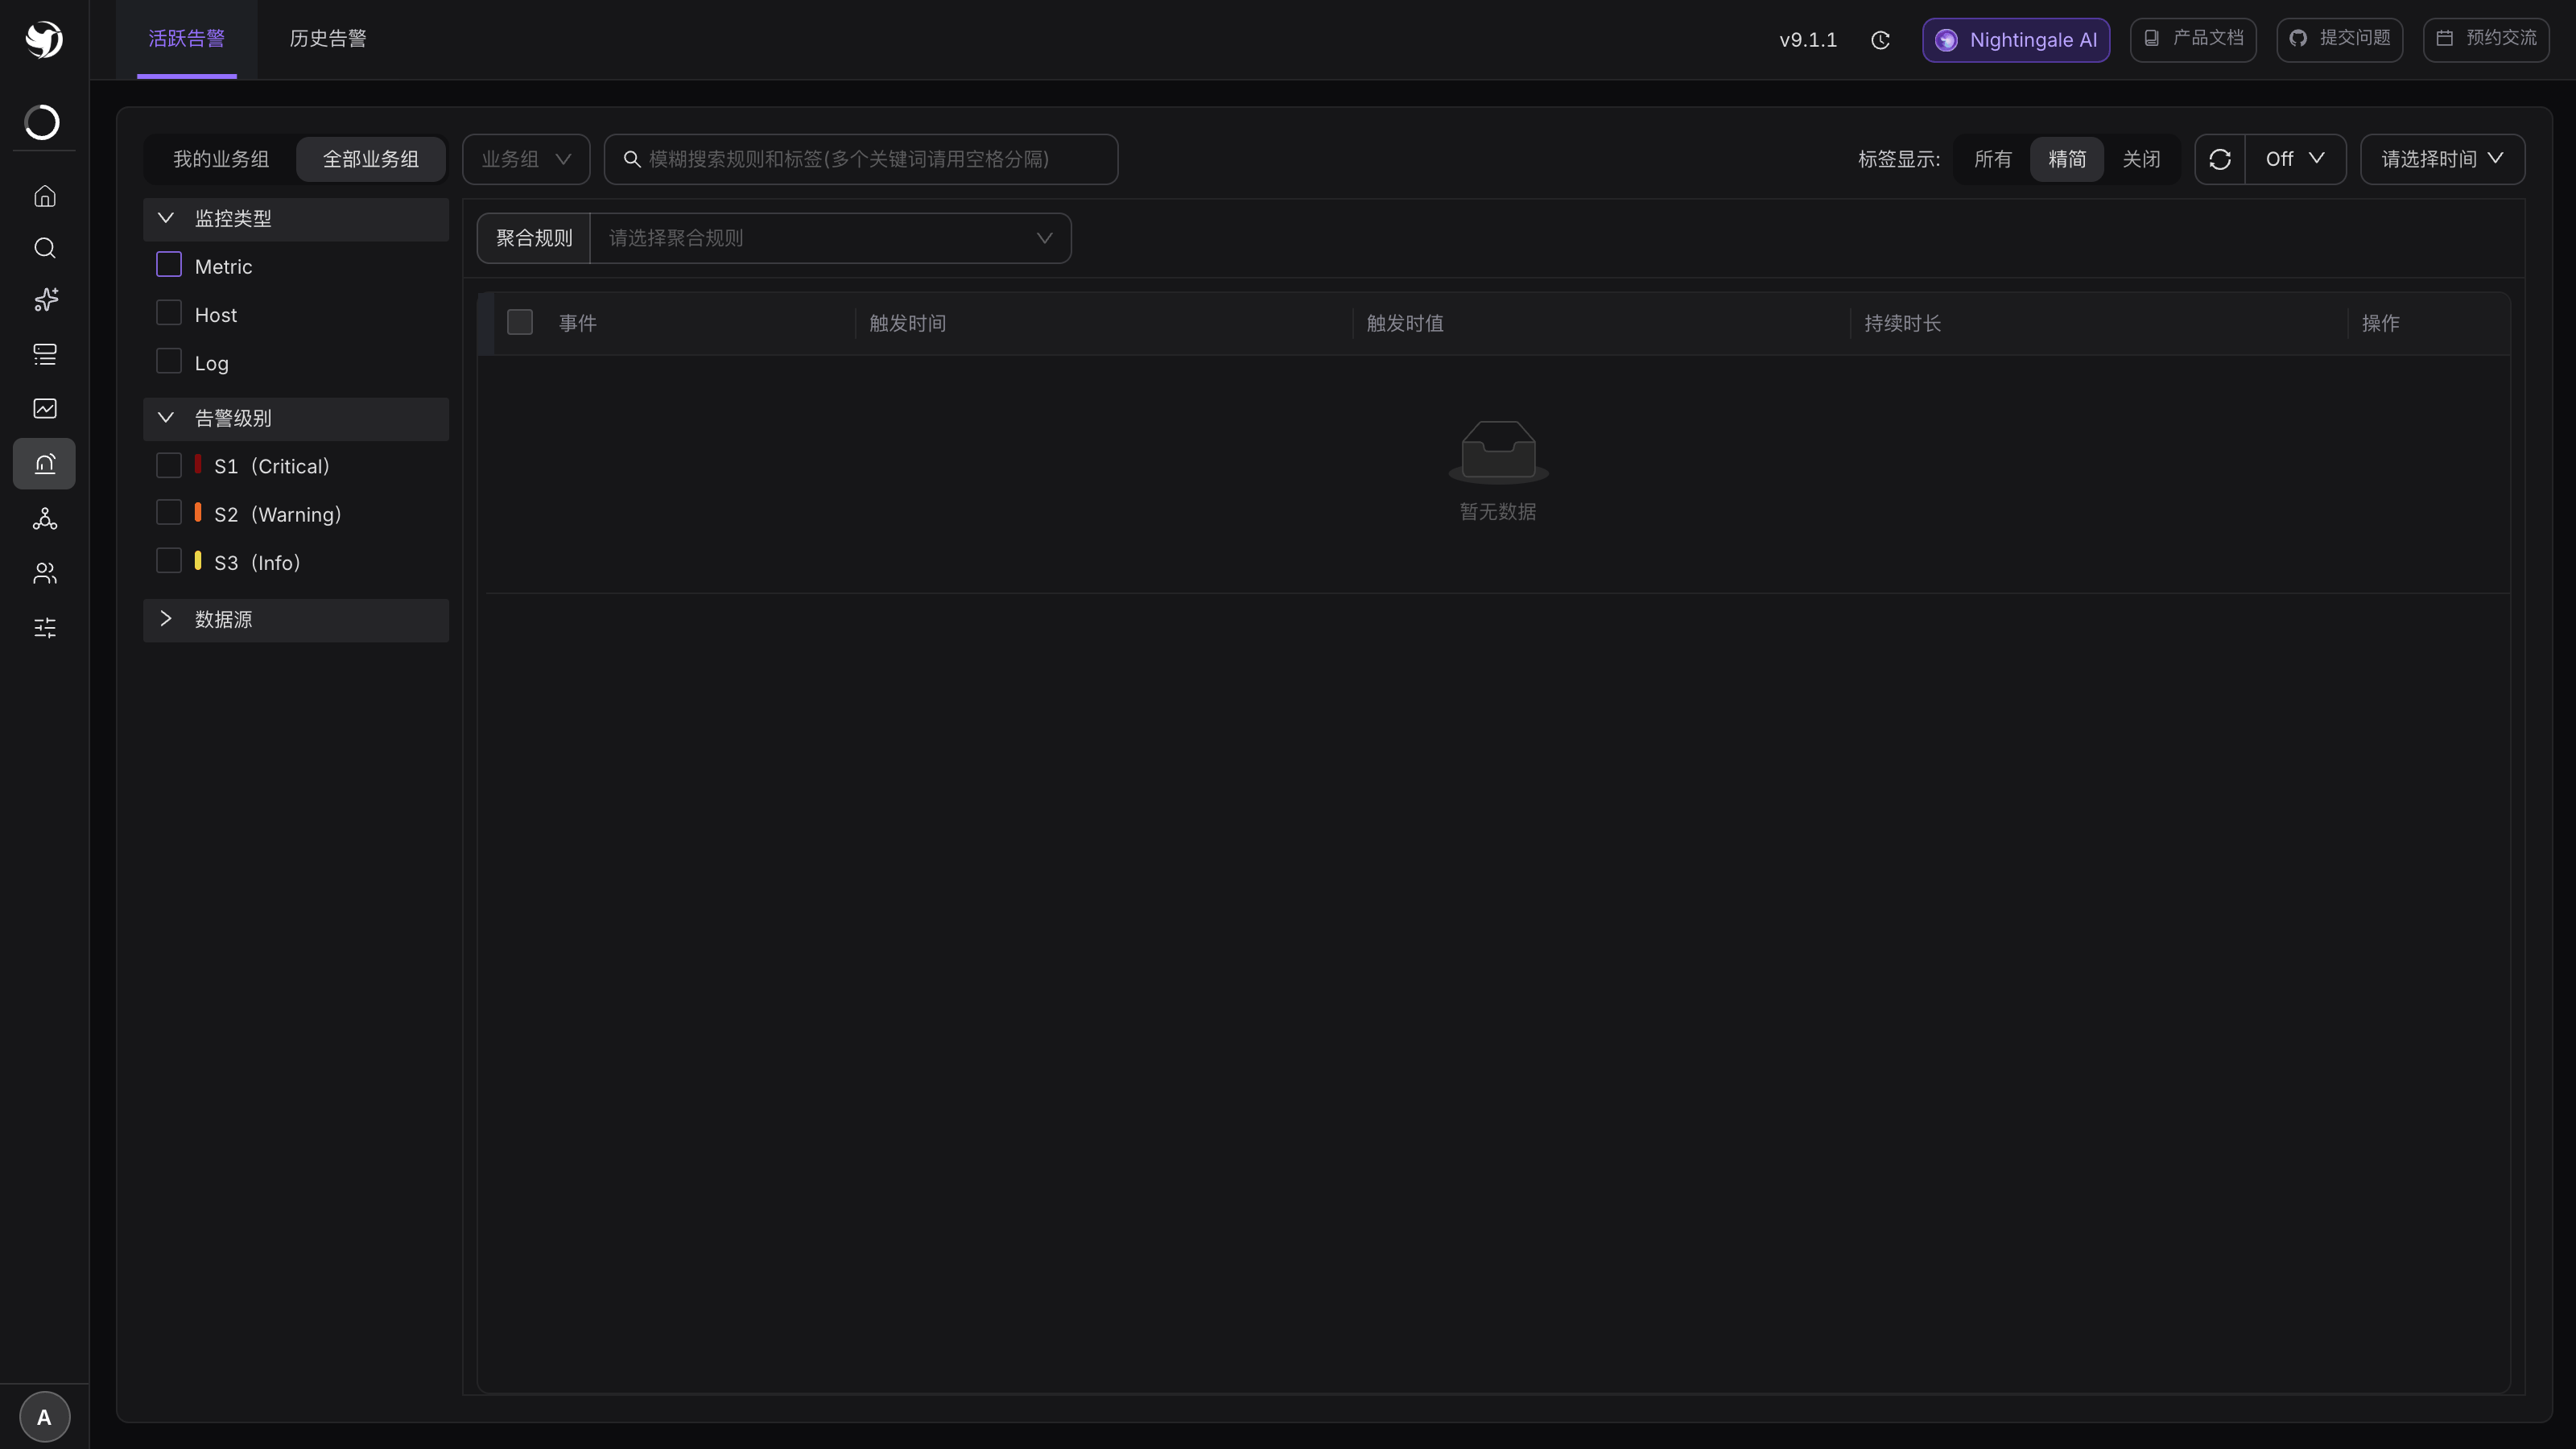
顶部一行:
- 我的业务组 / 全部业务组 加右侧的业务组下拉,两级收窄;
- 模糊搜索:同时在规则名和标签里搜,多个关键词用空格分隔,是「与」的关系。
输入
disk n9e-web-01会匹配规则名含 disk 且标签含 n9e-web-01 的事件; - 标签显示:所有 / 精简 / 关闭,值班大屏用「精简」最省地方;
- 自动刷新:默认 Off,可选 5s 到 5min。
左侧面板三组多选条件:监控类型(Metric / Host / Log)、告警级别(S1 Critical / S2 Warning / S3 Info)、数据源。三组之间是「与」。
表格里每行左边有一条竖色条,颜色就是级别;持续时长 那一格下面的彩条按时长从绿到红, 一眼能看出哪条烧得最久。
条数还是太多时,用列表上方的 聚合规则 把它们折成卡片,见 事件聚合与去重。
打开一条事件看什么
点事件标题(蓝色那行)从右侧滑出详情。除了规则名、级别、标签、首次触发时间、触发时值, 有三处值得专门看:
- 查询语句:规则实际执行的 PromQL / SQL,旁边有按钮直接拿去复算, 用来判断「是数据真的异常,还是阈值写错了」;
- 通知记录:这条事件被推到了哪些媒介、成没成功、失败的返回是什么。 收不到通知时先看这里,再看 有事件但收不到通知;
- Hash:事件指纹(规则 + 标签算出来的),排查「为什么这两条被当成同一个事件」时 直接复制比对。
底部三个按钮:
- 屏蔽:拿当前事件的标签预填一条屏蔽规则,跳到新建屏蔽页。这是最常用的止吵入口, 见屏蔽规则;
- 删除:物理删掉这条事件。只在确定这个指标再也不会上报时才用(机器下线、标签改名)—— 这类事件永远等不到恢复。其他情况让它自然恢复;
- 分享链接:签一条免登录的只读链接,默认 7 天,发给协作方看。机制和 匿名限时分享一样,只是分享的是一条事件。
批量处置
勾选多行后,列表上方出现批量操作。开源版能批量删除。
删除不等于屏蔽:规则本身没被禁用,下一个判定周期条件还成立的话,会重新烧出一条新事件 (Hash 可能和刚才那条一样)。想长期止吵,去屏蔽规则, 或者干脆停用规则。
历史事件:导出与清理
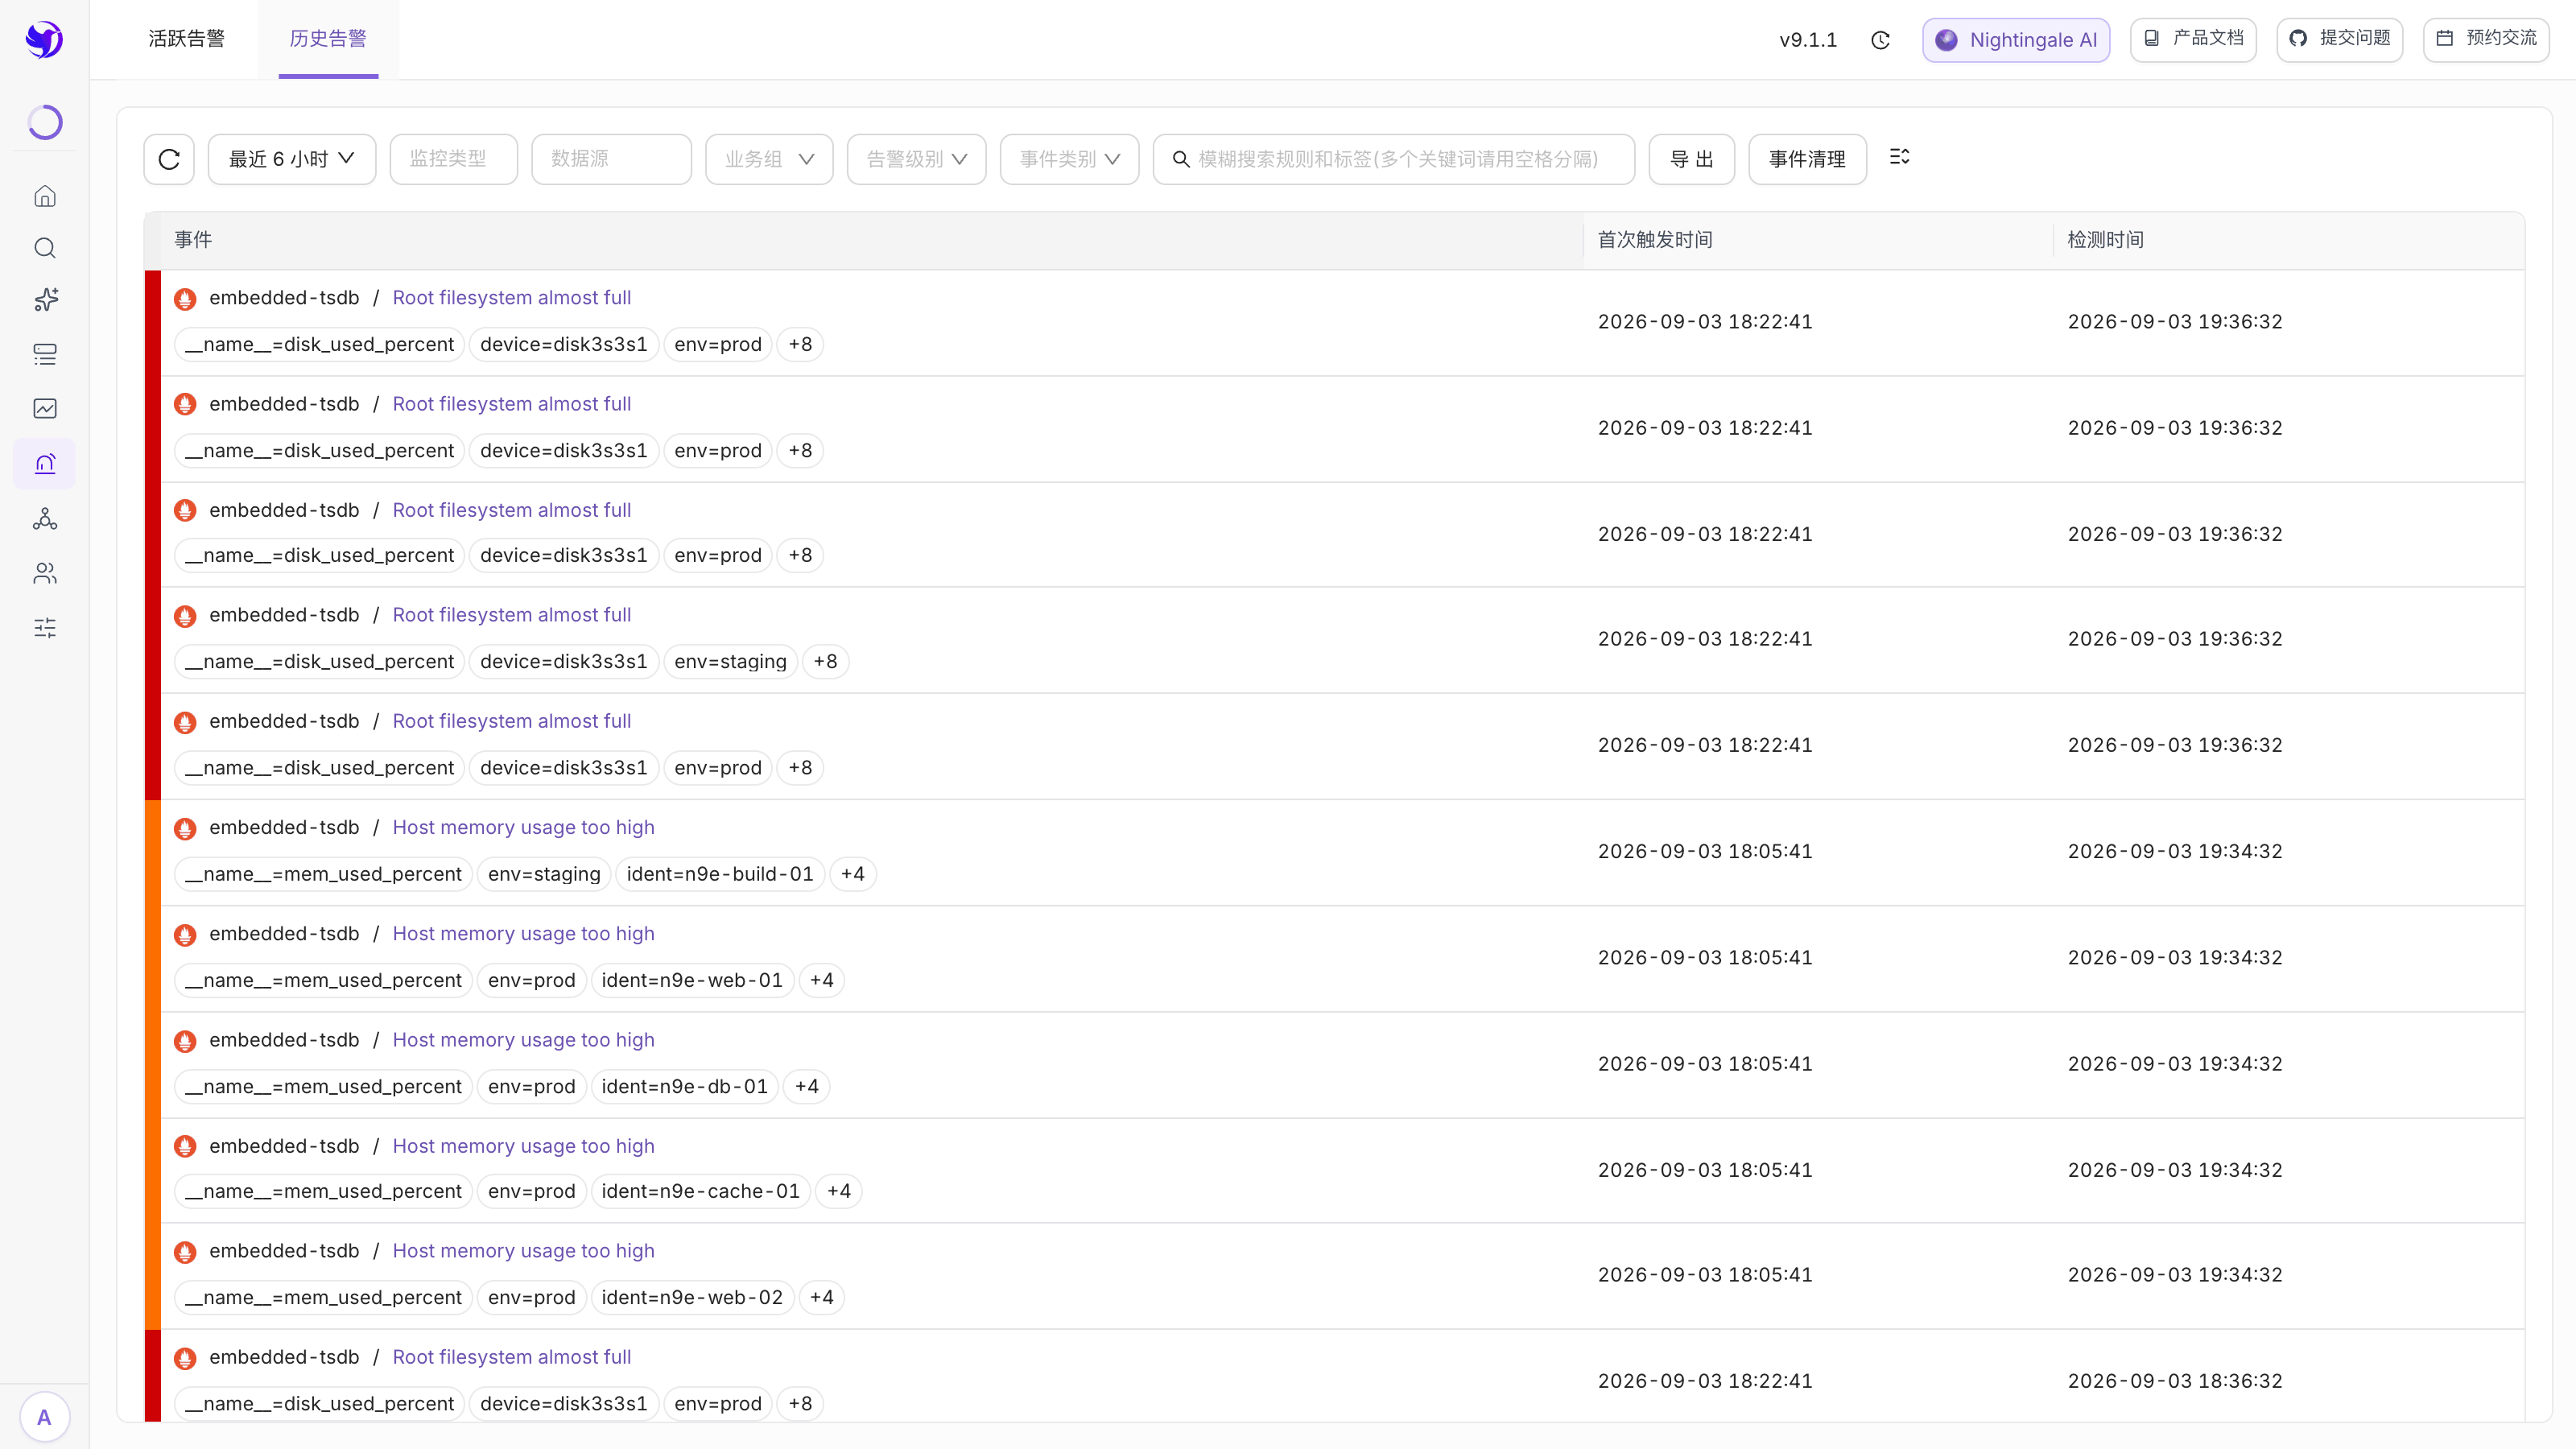
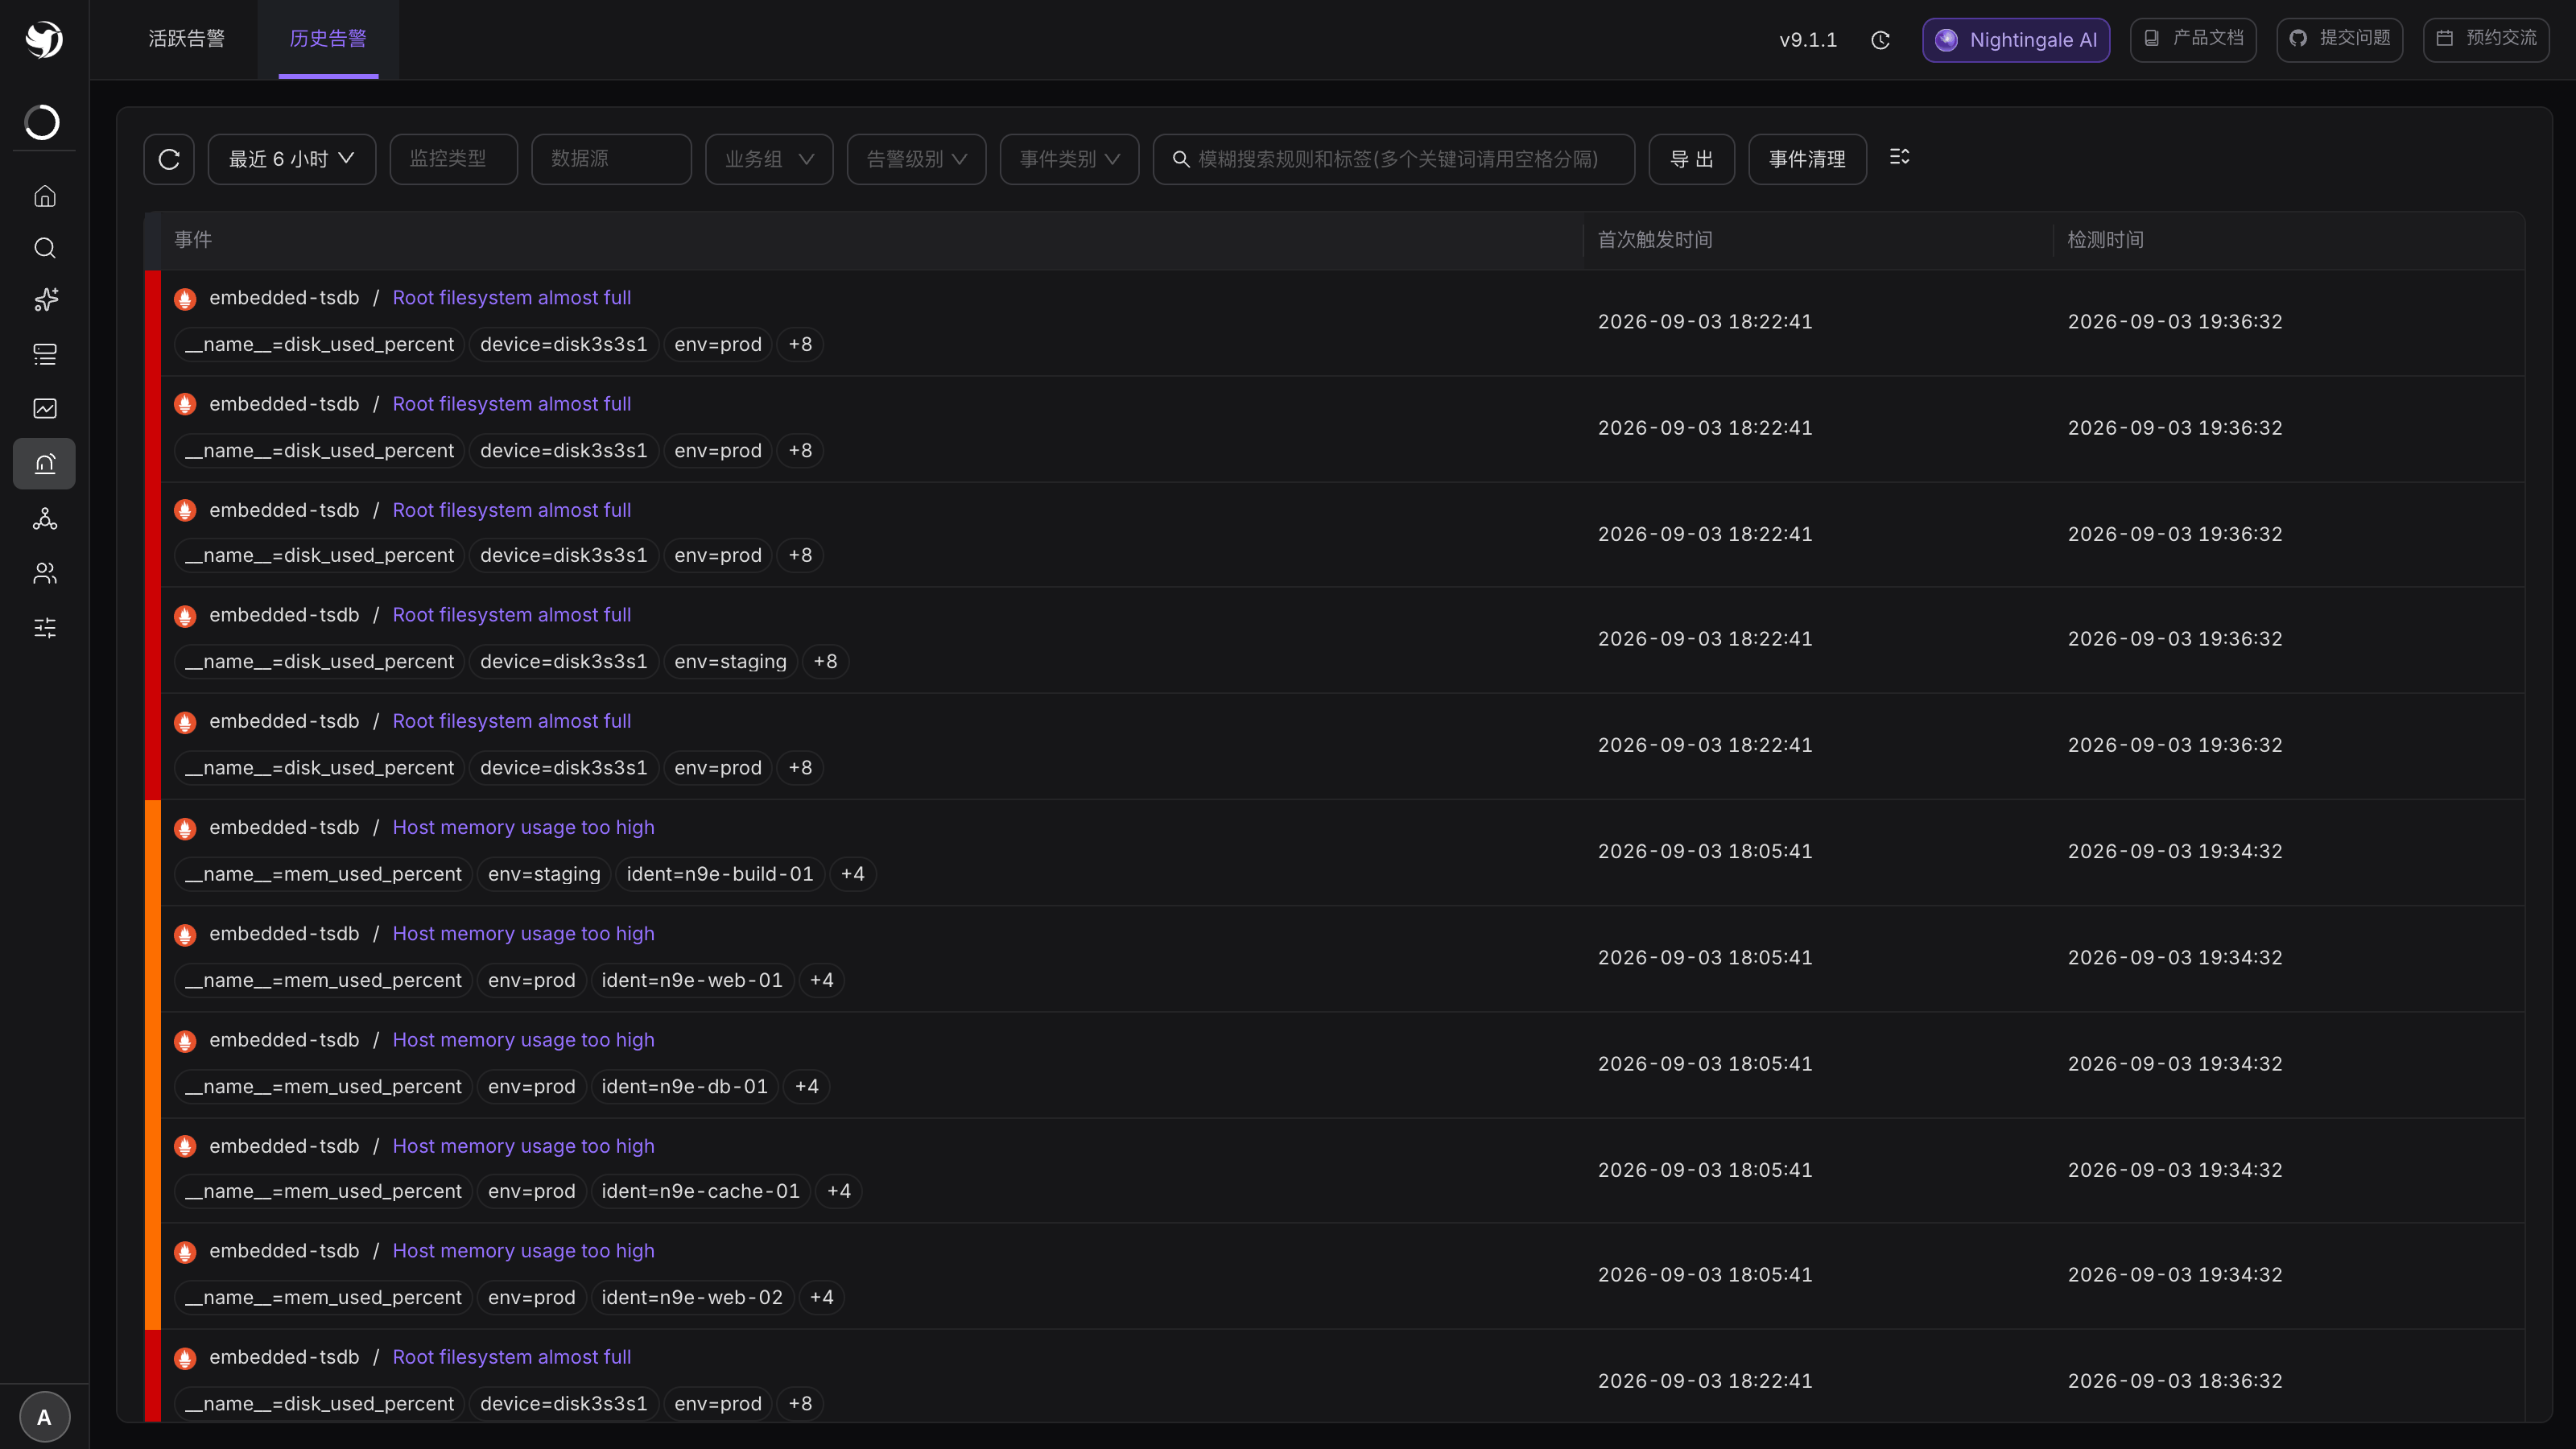
历史告警的列和活跃告警不同:首次触发时间(第一次进告警状态)和 检测时间(最后一次判定确认它还在告警 / 已恢复)分成两列,复盘时间线时看这两个。
右上两个按钮:
- 导出:把当前筛选条件命中的事件导出,拿去做月度复盘;
- 事件清理:按「等级 + 早于 1 个月 / 3 个月 / 6 个月 / 1 年」批量删。 删了找不回来,先用筛选条件确认一遍命中范围再点。
历史事件不会自动过期,长期不清理会把表撑大,建议在上线检查里排一条定期清理。