查看 Pipeline 执行记录
Pipeline 执行记录逐事件记下每个处理器改了什么、事件是否被丢弃、最终送到了哪里。
这页办完你会能回答:某条事件进没进这条工作流、每个处理器把它改成了什么样、 它是不是在半路被丢掉了。
入口:告警通知 → 工作流,顶部切到 执行记录 tab(/event-pipelines-executions)。
工作流列表里点某条工作流的执行记录,是同一张表加了工作流筛选。
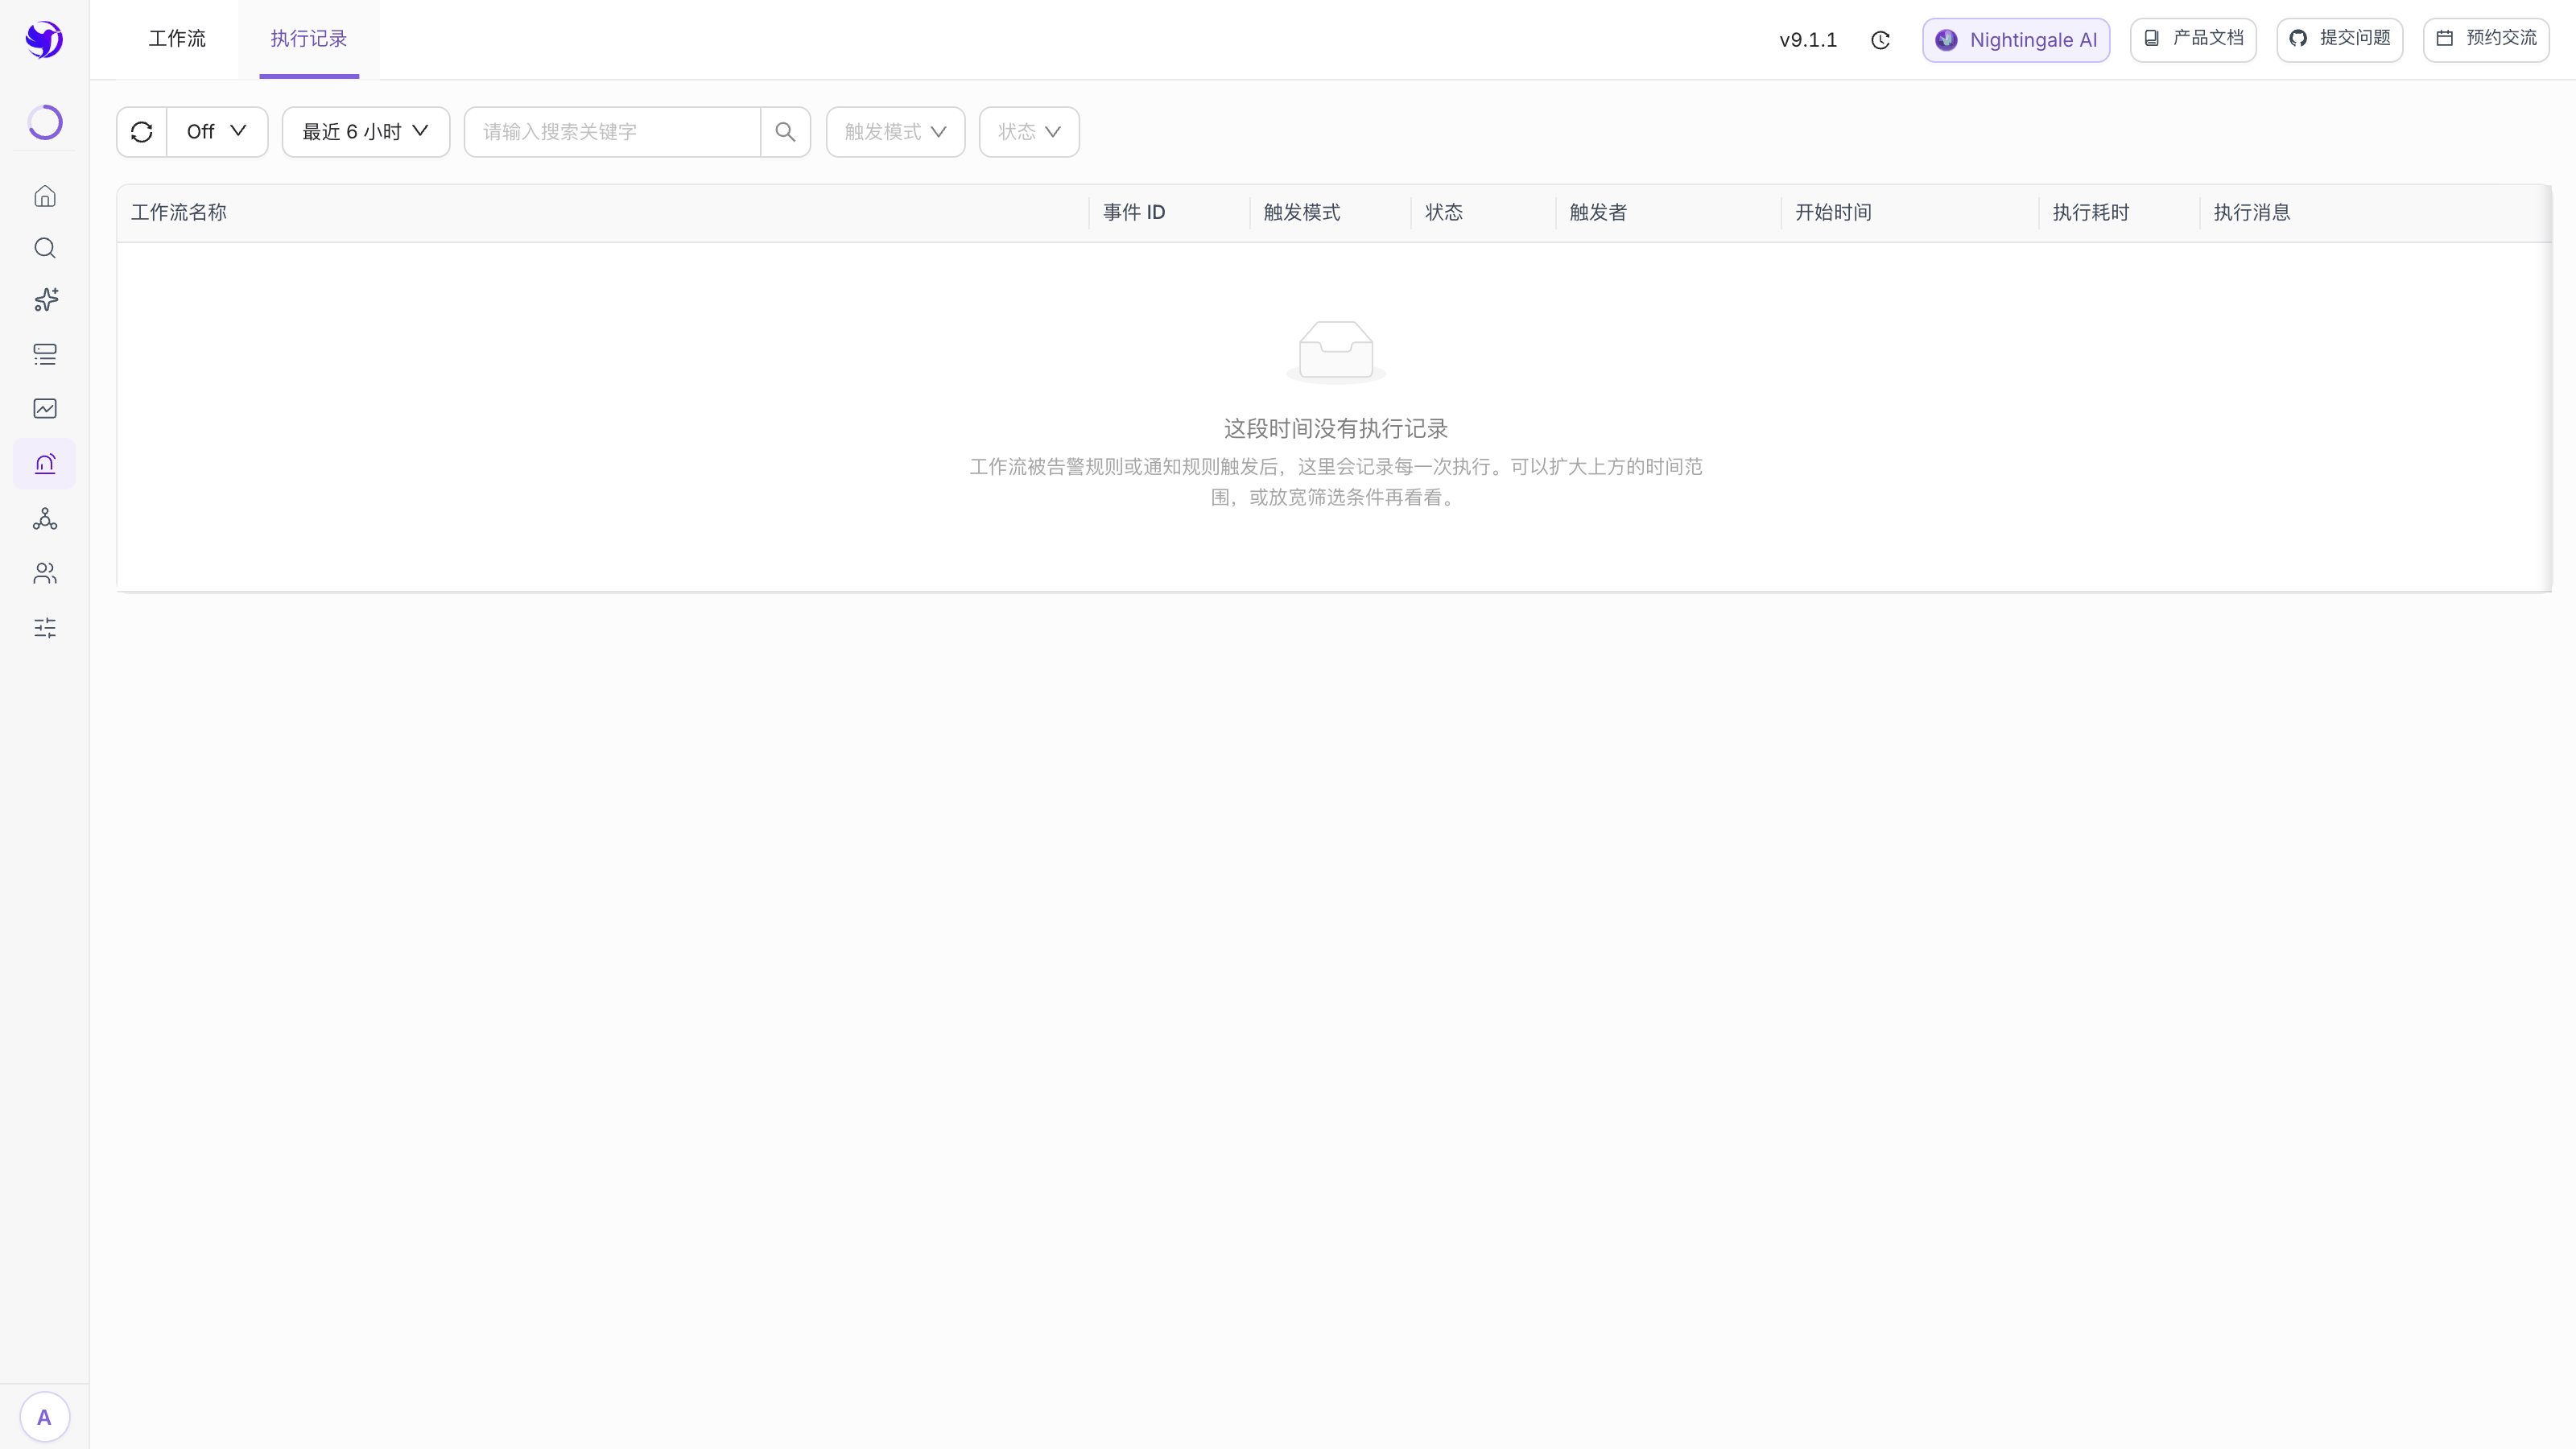
先把时间范围放宽
默认只看最近 6 小时。查不到记录时,第一件事是把时间范围往大调, 而不是怀疑工作流没生效——空状态里也是这么写的。
工具栏另外三个筛选:关键字、触发模式、状态。
列表上的每一列
| 列 | 怎么读 |
|---|---|
| 工作流名称 | 记录的是执行当时的名字,工作流后来改名不影响老记录 |
| 事件 ID | 对应的告警事件;没有事件的执行(比如试跑一条不存在的事件)这里是空的 |
| 触发模式 | 告警触发(正常链路上跑的)或 API 触发(试跑和接口调用) |
| 状态 | 运行中 / 成功 / 失败 |
| 触发者 | 告警触发时是「告警规则 #id」或「通知规则 #id」,一眼看出是哪个挂载点;API 触发时是用户名 |
| 开始时间 | 这次执行的起点 |
| 执行耗时 | 毫秒。亚毫秒的执行显示 0,那是有效值不是缺数据 |
| 执行消息 | 中性的结果描述,不一定是错误 |
「执行消息」里有内容不等于出错。 事件被丢弃时状态仍然是成功,消息是
workflow terminated at node X——工作流按你配的规矩正常结束了。只有状态为失败的行,
消息才会标红。
展开一条记录
点行打开详情抽屉:
- 基本信息:执行 ID、工作流、事件 ID、触发模式、起止时间、耗时;
- 节点执行结果:逐个处理器一步一步列出来,这是最有用的一段;
- 失败节点 / 错误信息:状态为失败时才有,直接指出卡在哪个处理器;
- 输入变量快照:这次执行用的变量值(脱敏后存的),排查「换了环境为什么行为不同」用它。
节点结果里的消息按处理器类型不同:
- 事件丢弃:「条件命中,事件已丢弃」或「条件未命中,事件继续往下走」。 后者是最常见也最正常的结果;
- 事件标签改写:给出标签改写前后的差异串,没改动时是「无变化」;
- Webhook 回调 / 事件更新:外部接口的返回。
事件被丢弃的那个节点后面,不会再有节点结果——后续处理器根本没执行。
用它排查三类问题
- 「工作流没生效」:先看有没有记录。一条都没有,说明事件压根没进来—— 多半是作用范围的适用标签/属性没匹配上,或者工作流没被规则引用。
- 「改了标签但通知里没变」:找到那条事件的记录,看标签改写节点的差异串。 差异串是对的但通知不对,问题在消息模板,见消息模板。
- 「事件莫名其妙没了」:搜这条事件的 ID,看是不是被事件丢弃处理器吃掉了。
状态会是成功,消息里带
terminated at node。
记录从哪来、留多久
- 挂在告警规则或通知规则上、被真实事件触发的每一次执行,都会写一条记录;
- 整条工作流的试跑也会写一条,触发模式是 API 触发、触发者是你的用户名;
- 单个处理器的试跑不写记录,它不经过工作流引擎。
记录会自动清理:每天 06:00 有个任务删掉早于 [Center] CleanPipelineExecutionDay 的记录,
每批 100 条,避免大批量删除压垮数据库。这个配置项默认是注释掉的,兜底值是 7 天——
不管它就是留一周,不是一直留着。另外还有一个只对管理员开放的清理接口,界面上没有入口。
工作流跑得频繁的实例,
把这张表的增长纳入容量规划,见容量规划。
下一步
- 上线前先在这里之外验证一遍:用模拟事件试跑
- 工作流本身怎么配:事件 Pipeline
- 试跑通了线上不生效:工作流试跑通过但线上不生效