内置指标与健康检查
每个进程暴露的 /metrics 与健康检查端点,以及值得画出来的那几个。
n9e、n9e-edge、n9e-alert、n9e-pushgw 用的是同一套 HTTP 骨架,
所以下面这几个端点在哪个进程上都一样,只是端口不同(Center 17000,edge 19000)。
每个进程都有的端点
| 端点 | 返回 | 用途 |
|---|---|---|
GET /ping | pong | 负载均衡和 K8s 探针用这个,最轻 |
GET /pid | 进程 PID | 确认你连到的是哪个进程 |
GET /ppid | 父进程 PID | 判断是不是被 supervisor 拉起来的 |
GET /addr | 请求方的地址 | 排查「我到底是从哪个 IP 连过来的」 |
GET /api/n9e/version | 版本号,例如 v9.1.1 | 滚动升级时逐个实例确认版本 |
GET /metrics | Prometheus 格式的自身指标 | 见下一节 |
GET /api/debug/pprof/* | Go pprof | 排查 CPU / 内存,见日志与诊断包 |
GET /dumper/sync | 各类配置的同步状态 | 只接受本机请求,排查「改了配置没生效」 |
验一下:
curl --noproxy '*' http://n9e:17000/ping           # pong
curl --noproxy '*' http://n9e:17000/api/n9e/version # v9.1.1
/ping 只证明 HTTP 服务还在监听,不代表数据库连得上、规则在判定。
真正的健康判断要看 /metrics。
两个开关:[HTTP] ExposeMetrics 默认 true,[HTTP] PProf 在 etc/config.toml 里默认 true、
在 etc/edge/edge.toml 里默认 false。
值得画出来的指标
/metrics 上有几千行,其中绝大多数是 Go 运行时和逐路由的 HTTP 直方图。
真正会告诉你「系统还在正常工作吗」的是下面这些。
判定还在跑吗
| 指标 | 说明 |
|---|---|
n9e_center_uptime | 进程启动至今的秒数,突然归零就是重启了(只有 Center 有这个指标) |
n9e_alert_rule_eval_total | 规则判定总次数,不带标签。这个数不涨就是判定停了 |
n9e_alert_rule_eval_error_total | 判定报错,标签 datasource / stage / busi_group / rule_id |
n9e_alert_rule_eval_duration_ms | 单条规则最近一次判定耗时,标签 rule_id / datasource_id |
n9e_alert_query_data_error_total | 查数据源失败次数,标签 datasource |
n9e_alert_alerts_total | 产生的告警事件总数,标签 cluster / type / busi_group |
n9e_alert_alert_queue_size | 内存中待处理的事件队列长度,持续不为 0 说明处理跟不上 |
数据还在进来吗
| 指标 | 说明 |
|---|---|
n9e_pushgw_samples_received_total | 收到的样本总数,标签 channel(prometheus、opentsdb 等) |
n9e_pushgw_sample_received_by_ident | 按机器标识分的样本数,标签 host_ident。哪台机器不报数一眼看得出 |
n9e_pushgw_sample_queue_size | 转发队列长度,标签 queueid(队列数默认等于 CPU 核数) |
n9e_pushgw_push_queue_over_limit_error_total | 队列水位超限、整个 remote write 请求被拒的次数 |
n9e_pushgw_push_queue_error_total | 某个队列写满导致丢弃的样本数,标签 queueid |
n9e_pushgw_drop_sample_total | 被丢弃规则过滤掉的样本数 |
n9e_pushgw_write_total / n9e_pushgw_forward_duration_seconds | 写出去的样本数和耗时,标签 url |
依赖还健康吗
| 指标 | 说明 |
|---|---|
n9e_db_pool_open_connections / n9e_db_pool_in_use_connections | 连接池占用,逼近 [DB] MaxOpenConns 就是要排队了 |
n9e_db_pool_wait_count_total / n9e_db_pool_wait_duration_seconds_total | 等连接的次数和总时长,非 0 就该调池子或看慢查询 |
n9e_db_operation_total | 数据库操作数,标签 operation / status / table |
n9e_center_redis_operation_latency_seconds | Redis 操作耗时直方图 |
n9e_center_http_request_duration_seconds | HTTP 耗时直方图,标签 code / method / path |
内置时序库(只有开着 [EmbeddedTSDB] 的 Center 有)
内置时序库用的是 Prometheus 的存储引擎,所以它的指标就是标准的那一套:
prometheus_tsdb_head_series(当前活跃序列数)、prometheus_tsdb_head_samples_appended_total、
prometheus_tsdb_storage_blocks_bytes、prometheus_tsdb_wal_corruptions_total、
prometheus_engine_queries(正在执行或排队的查询数)。
告警引擎的心跳
指标之外还有一个更直观的地方:系统配置 → 告警引擎。 每个实例每秒往里写一次心跳,页面按引擎集群列出所有活着的实例。
「上次心跳时间」停在某个点不动,就是那个实例出问题了; 实例整行消失,说明它已经超过 30 秒没心跳、被移出哈希环了。
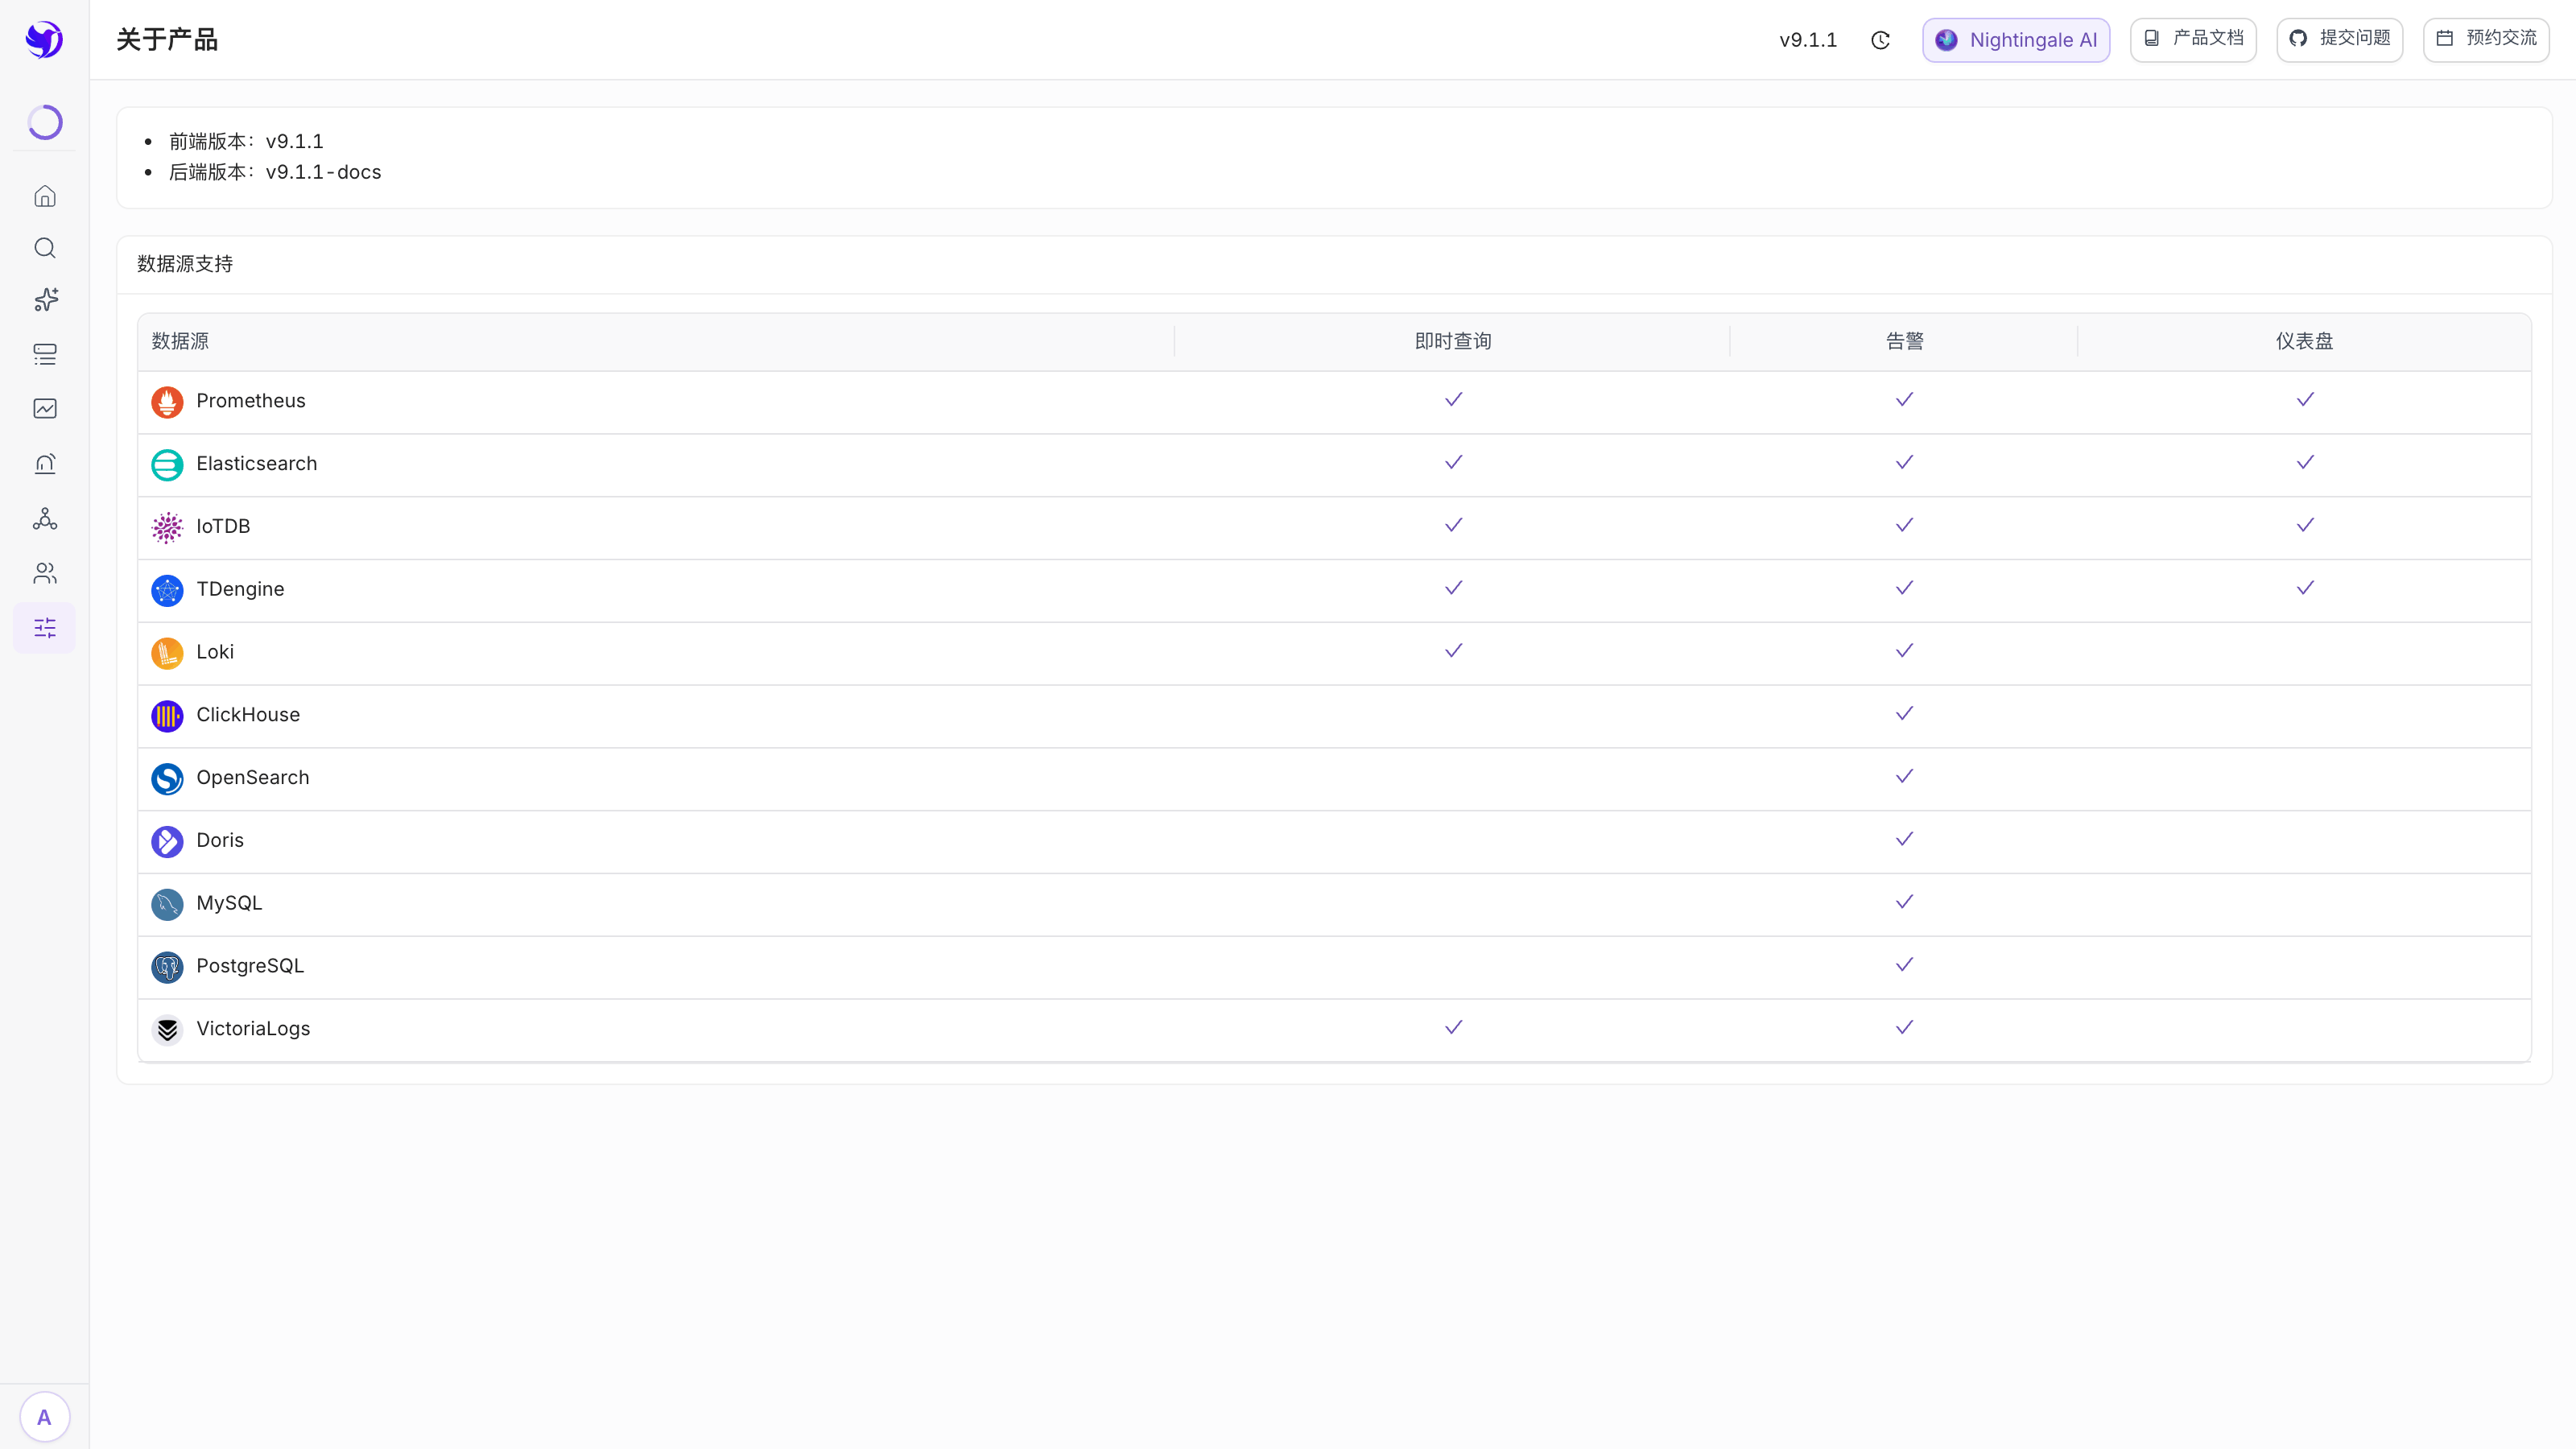
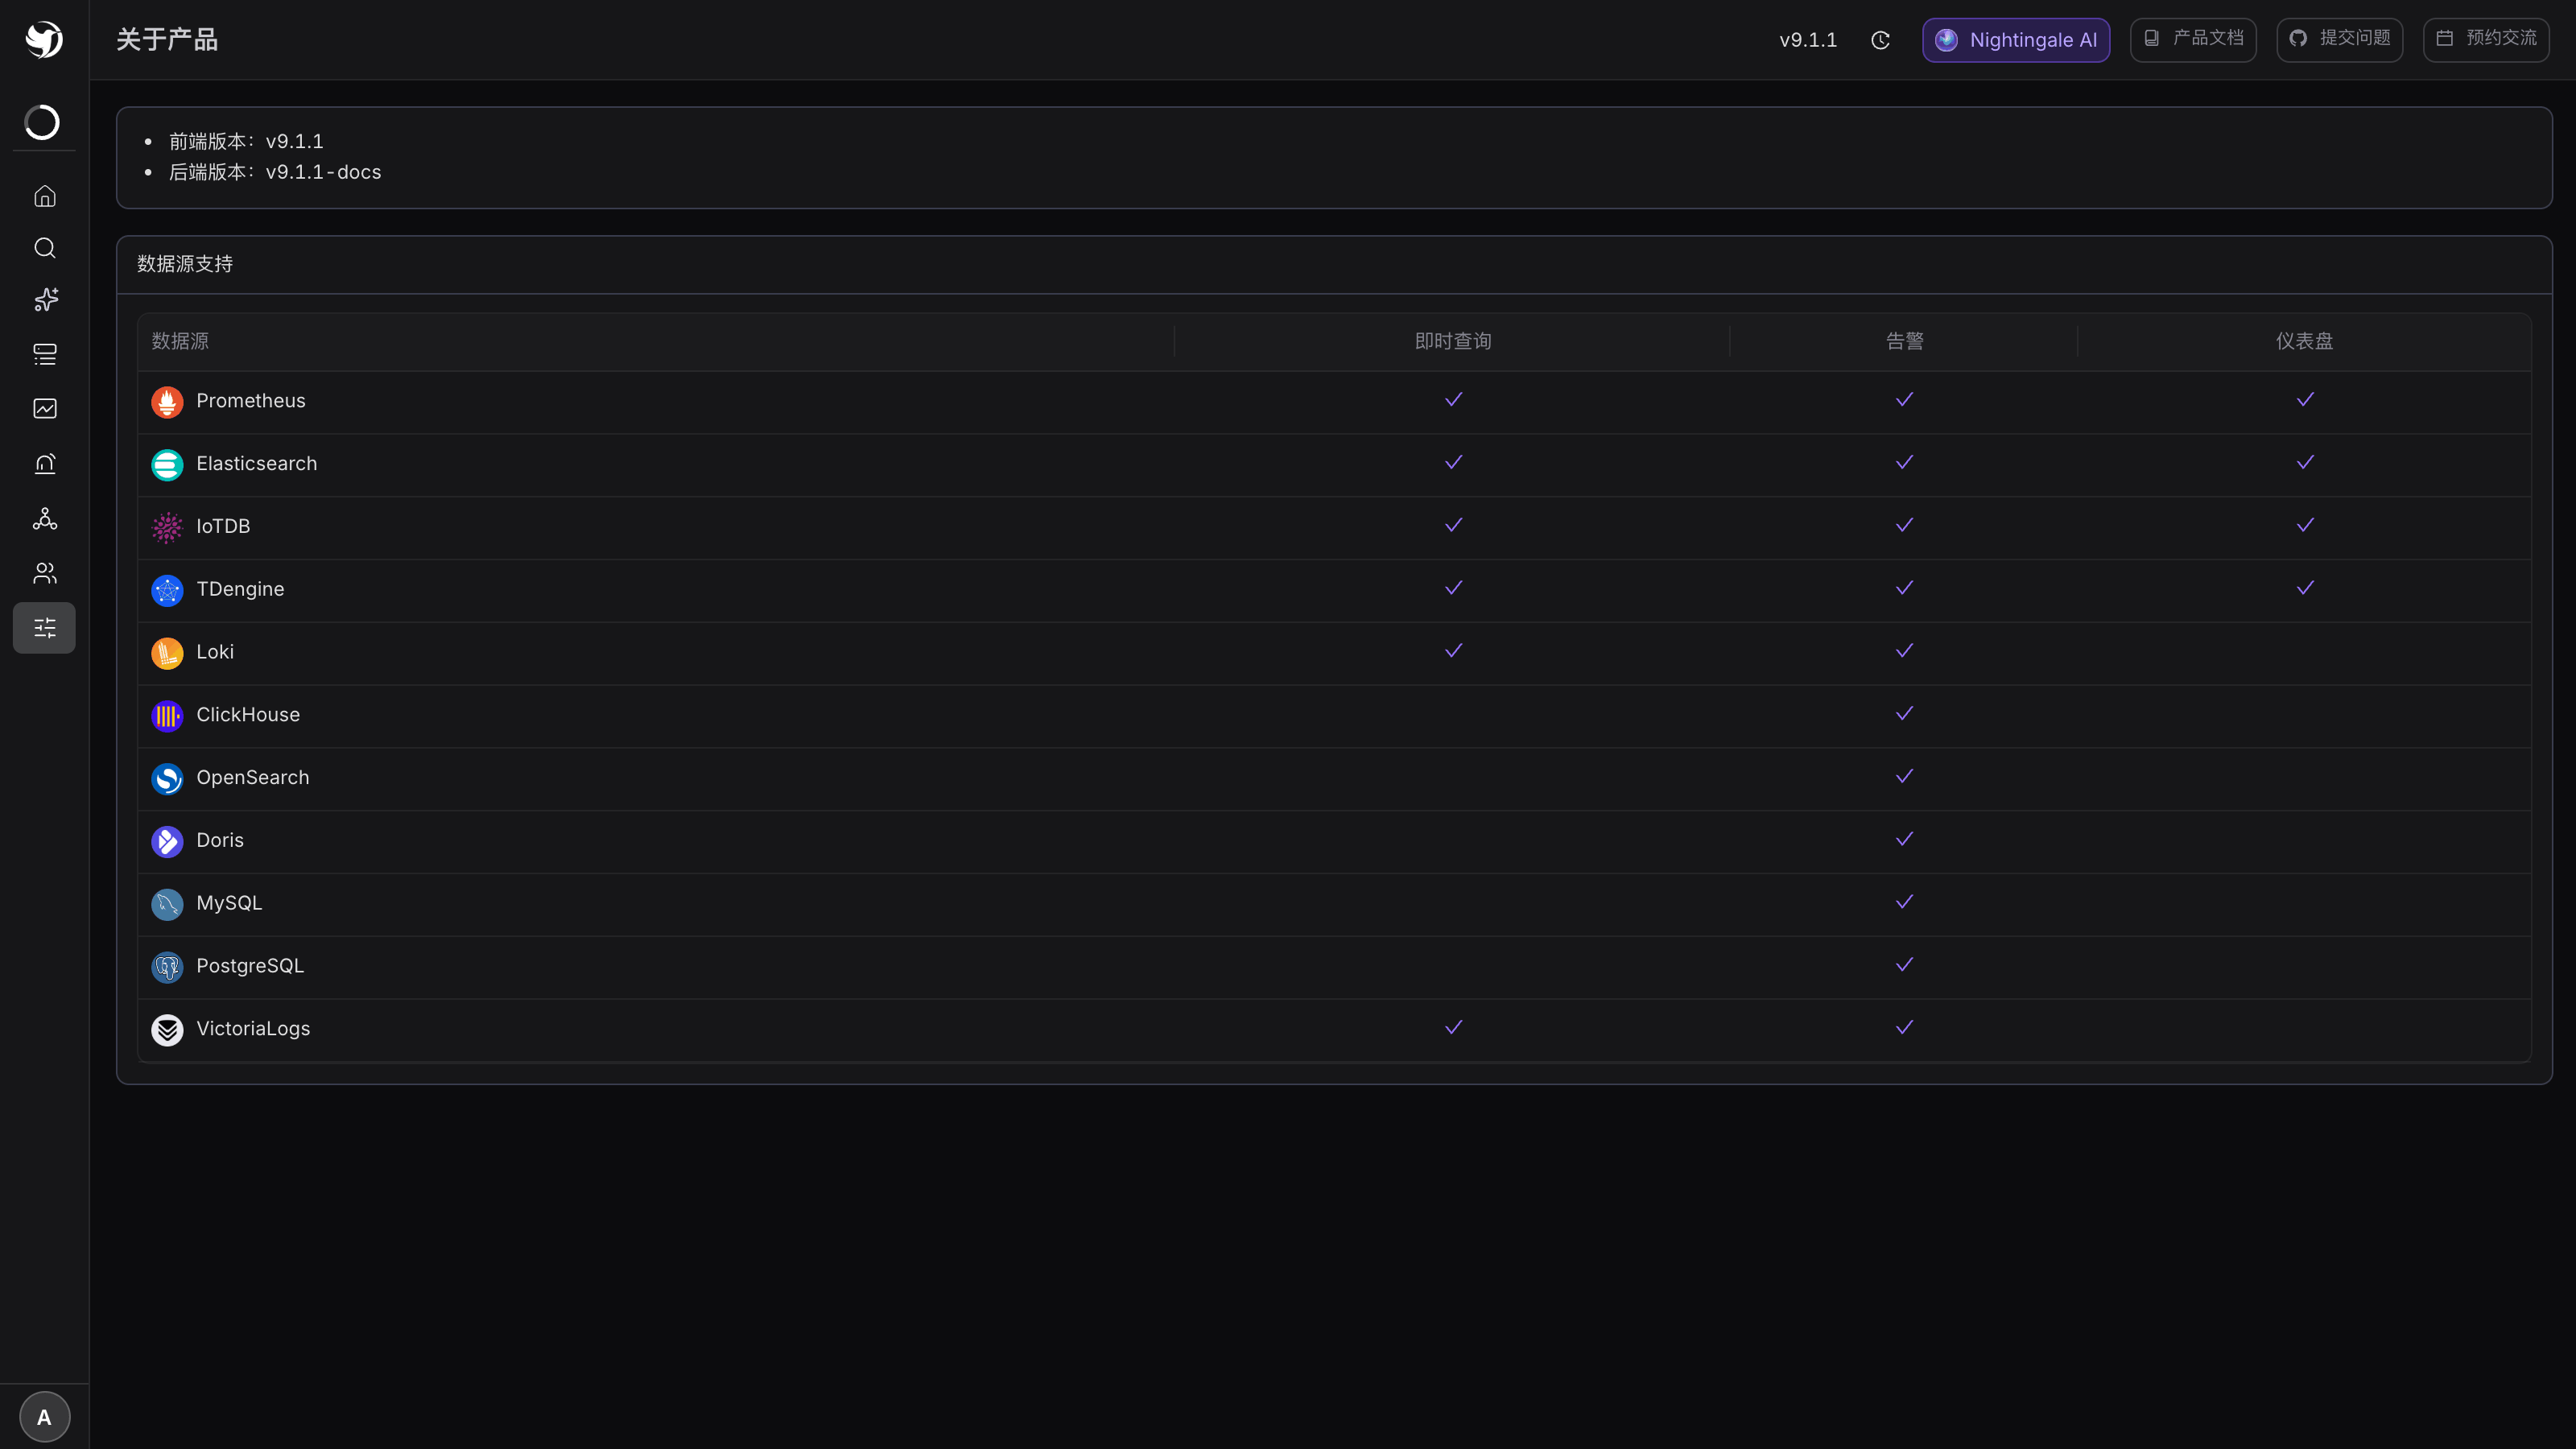
版本信息在系统配置 → 关于产品:前端版本、后端版本,以及各数据源支持哪些功能。
带标签的计数器一开始并不存在
Prometheus 的 CounterVec 只有在某个标签组合第一次被记录时才会出现在 /metrics 上。
所以刚启动的实例上,n9e_alert_rule_eval_error_total、n9e_alert_query_data_error_total
这些根本不存在,不是等于 0。
这会坑到两类写法:
- 用
absent(n9e_alert_rule_eval_error_total)判断「有没有错误」——它在一切正常时永远告警; - 直接对错误计数做阈值告警而不加
rate()——首次出现时会从无到有跳一下。
可靠的写法是对一定会存在的指标做判断,比如 n9e_alert_rule_eval_total 的增长率。
具体规则见监控夜莺自身。
把这些端点收口
/metrics、/api/debug/pprof/* 都不需要认证,而它们和 Web UI、写入端点共用同一个端口。
生产上:
[HTTP] PProf = false,需要抓 profile 时临时打开;/metrics只让内网的采集器访问,网关上按路径放行;/dumper/sync本身就只接受本机请求,不用额外处理。