升级与数据库迁移
schema 迁移在启动时怎么跑,以及多实例部署该按什么顺序升级。
换二进制的命令在升级里。这页讲运行侧的另一半: 进程启动时会对你的库做什么,以及从第一个实例停掉到最后一个实例回来的这段时间里, 多实例部署是什么样子。
迁移在进程启动时跑,没有单独的命令
没有迁移命令,也没有迁移状态表。n9e 连上元数据库之后——在连 Redis 之前、
在建内存缓存之前、在监听端口之前——就用 GORM 的 AutoMigrate 把编译进二进制的那份模型列表
过一遍。新版本需要的表和列要么这时出现,要么就没有。
由此带来两条性质,都很重要:
- 它只增不减。 缺的表、列、索引会被建出来,但从不删任何东西,也不记录改之前的样子。 所以不存在反向迁移——见回滚。
- schema 的来源是模型,不是仓库里的 SQL 文件。
docker/sqlite.sql和docker/initsql/a-n9e.sql是全新安装用的,而且落后于代码:sqlite.sql里 根本没有notify_rule、notify_channel_config、message_template、event_pipeline、ai_llm_config这些表。它们在跑着的 v9 里存在,纯粹是 AutoMigrate 建出来的。 别拿线上的表结构去和这两个文件比对,来判断升级有没有成功。
启动顺序,按「哪一步会失败」排列:
| 步骤 | 失败了会怎样 |
|---|---|
| 连接元数据库 | 进程直接退出 |
| 跑 schema 迁移 | 记一行日志,继续启动 |
| 建 root 用户、JWT 签名密钥 | 记一行日志,继续启动 |
| 连接 Redis | 进程直接退出 |
| 把配置加载进内存缓存、启动告警引擎 | 规则不判定 |
| 监听 17000 | 端口被占,进程退出 |
分两批:小表挡启动,大表不挡
| 批次 | 覆盖 | 是否挡启动 |
|---|---|---|
| 同步 | 除事件表以外的所有表——规则、用户、数据源、通知配置 | 挡 |
| 异步 goroutine | alert_cur_event、alert_his_event,外加三个索引 | 不挡 |
异步这一批还要建三个索引,落在两张会无限长大的表上——而且建法不一样:
notification_record上那两个是刻意不挡写的:MySQL 上显式带ALGORITHM=INPLACE, LOCK=NONE, PostgreSQL 上走CREATE INDEX CONCURRENTLY。MySQL 上在线加不了索引时它宁可报错, 也不会静默退化成阻塞写入的 DDL;alert_his_event上的idx_group_last_eval_time是普通的CREATE INDEX,没有这些子句。 在 PostgreSQL 上它整个构建期间会持有该表的共享锁,把写入挡住——而alert_his_event通常就是你库里最大的那张表。PostgreSQL 上数据量大的部署,要预期历史事件在这段时间写不进去。
也就是说,库里最大的那张表还在改结构的时候,进程已经在回 /ping、在提供界面、
在判定规则了。alert_his_event 上了几个 GB 的话,这事要跑几十分钟。
不要为了「把它弄活」去重启:重启只会让同样的活儿从头再来一遍。
有一条警告是预期内的:如果 notification_record 还没有 notify_rule_id 列,
依赖这个列的那个索引会被跳过,日志写 will retry on next start,另一个索引照常建。
别管它。
迁移失败不会让进程停下来
每一条迁移错误都是记日志然后吞掉,迁移里的 panic 也会被 recover 掉。
这是有意为之——另一个实例或者下次重启会把 schema 补齐——但带来的后果很容易漏掉:
一个实例可以正常启动、正常服务、正常上报心跳,同时缺着它需要的某一列。
你不会看到启动失败,你会在好几天以后看到某一个功能在运行时报 Unknown column。
所以升级之后要做的检查是 grep 日志,不是看健康检查:
grep -iE "failed to migrate table|failed to create index" /opt/n9e/logs/*.log
预期结果:没有输出。有输出的话几乎都是权限问题——[DB] DSN 里那个账号能读能写,
但没有 CREATE / ALTER 权限。补上授权重启,或者按
v8 升级 v9 里的说法,把 docker/migratesql/migrate.sql
里对应版本的段落交给 DBA 执行。
先让一个实例把迁移跑完,再滚其余的
迁移代码里针对「多实例同时启动」写了两处显式防御,这说明这两件事是真会发生的:
- 两个实例并发对同一张表发
ALTER,会让 MySQL 驱动查列类型时解引用到空值。 panic 会被 recover,但这次启动里那个迁移入口就等于放弃了; - 大表
alert_his_event上重复执行的CREATE INDEX会卡在元数据锁上,把启动挂住—— 不是卡几秒,是一直卡着。
两种都不会弄坏数据,但都会白白搭进去一次启动,还得回头排查。避开这两件事的顺序是:
- 停一个实例,换二进制,起来。迁移由它来做。
- 等它的日志安静下来:没有
failed to migrate,索引也不再有动静。 - 然后才动下一个,之后一个一个来。
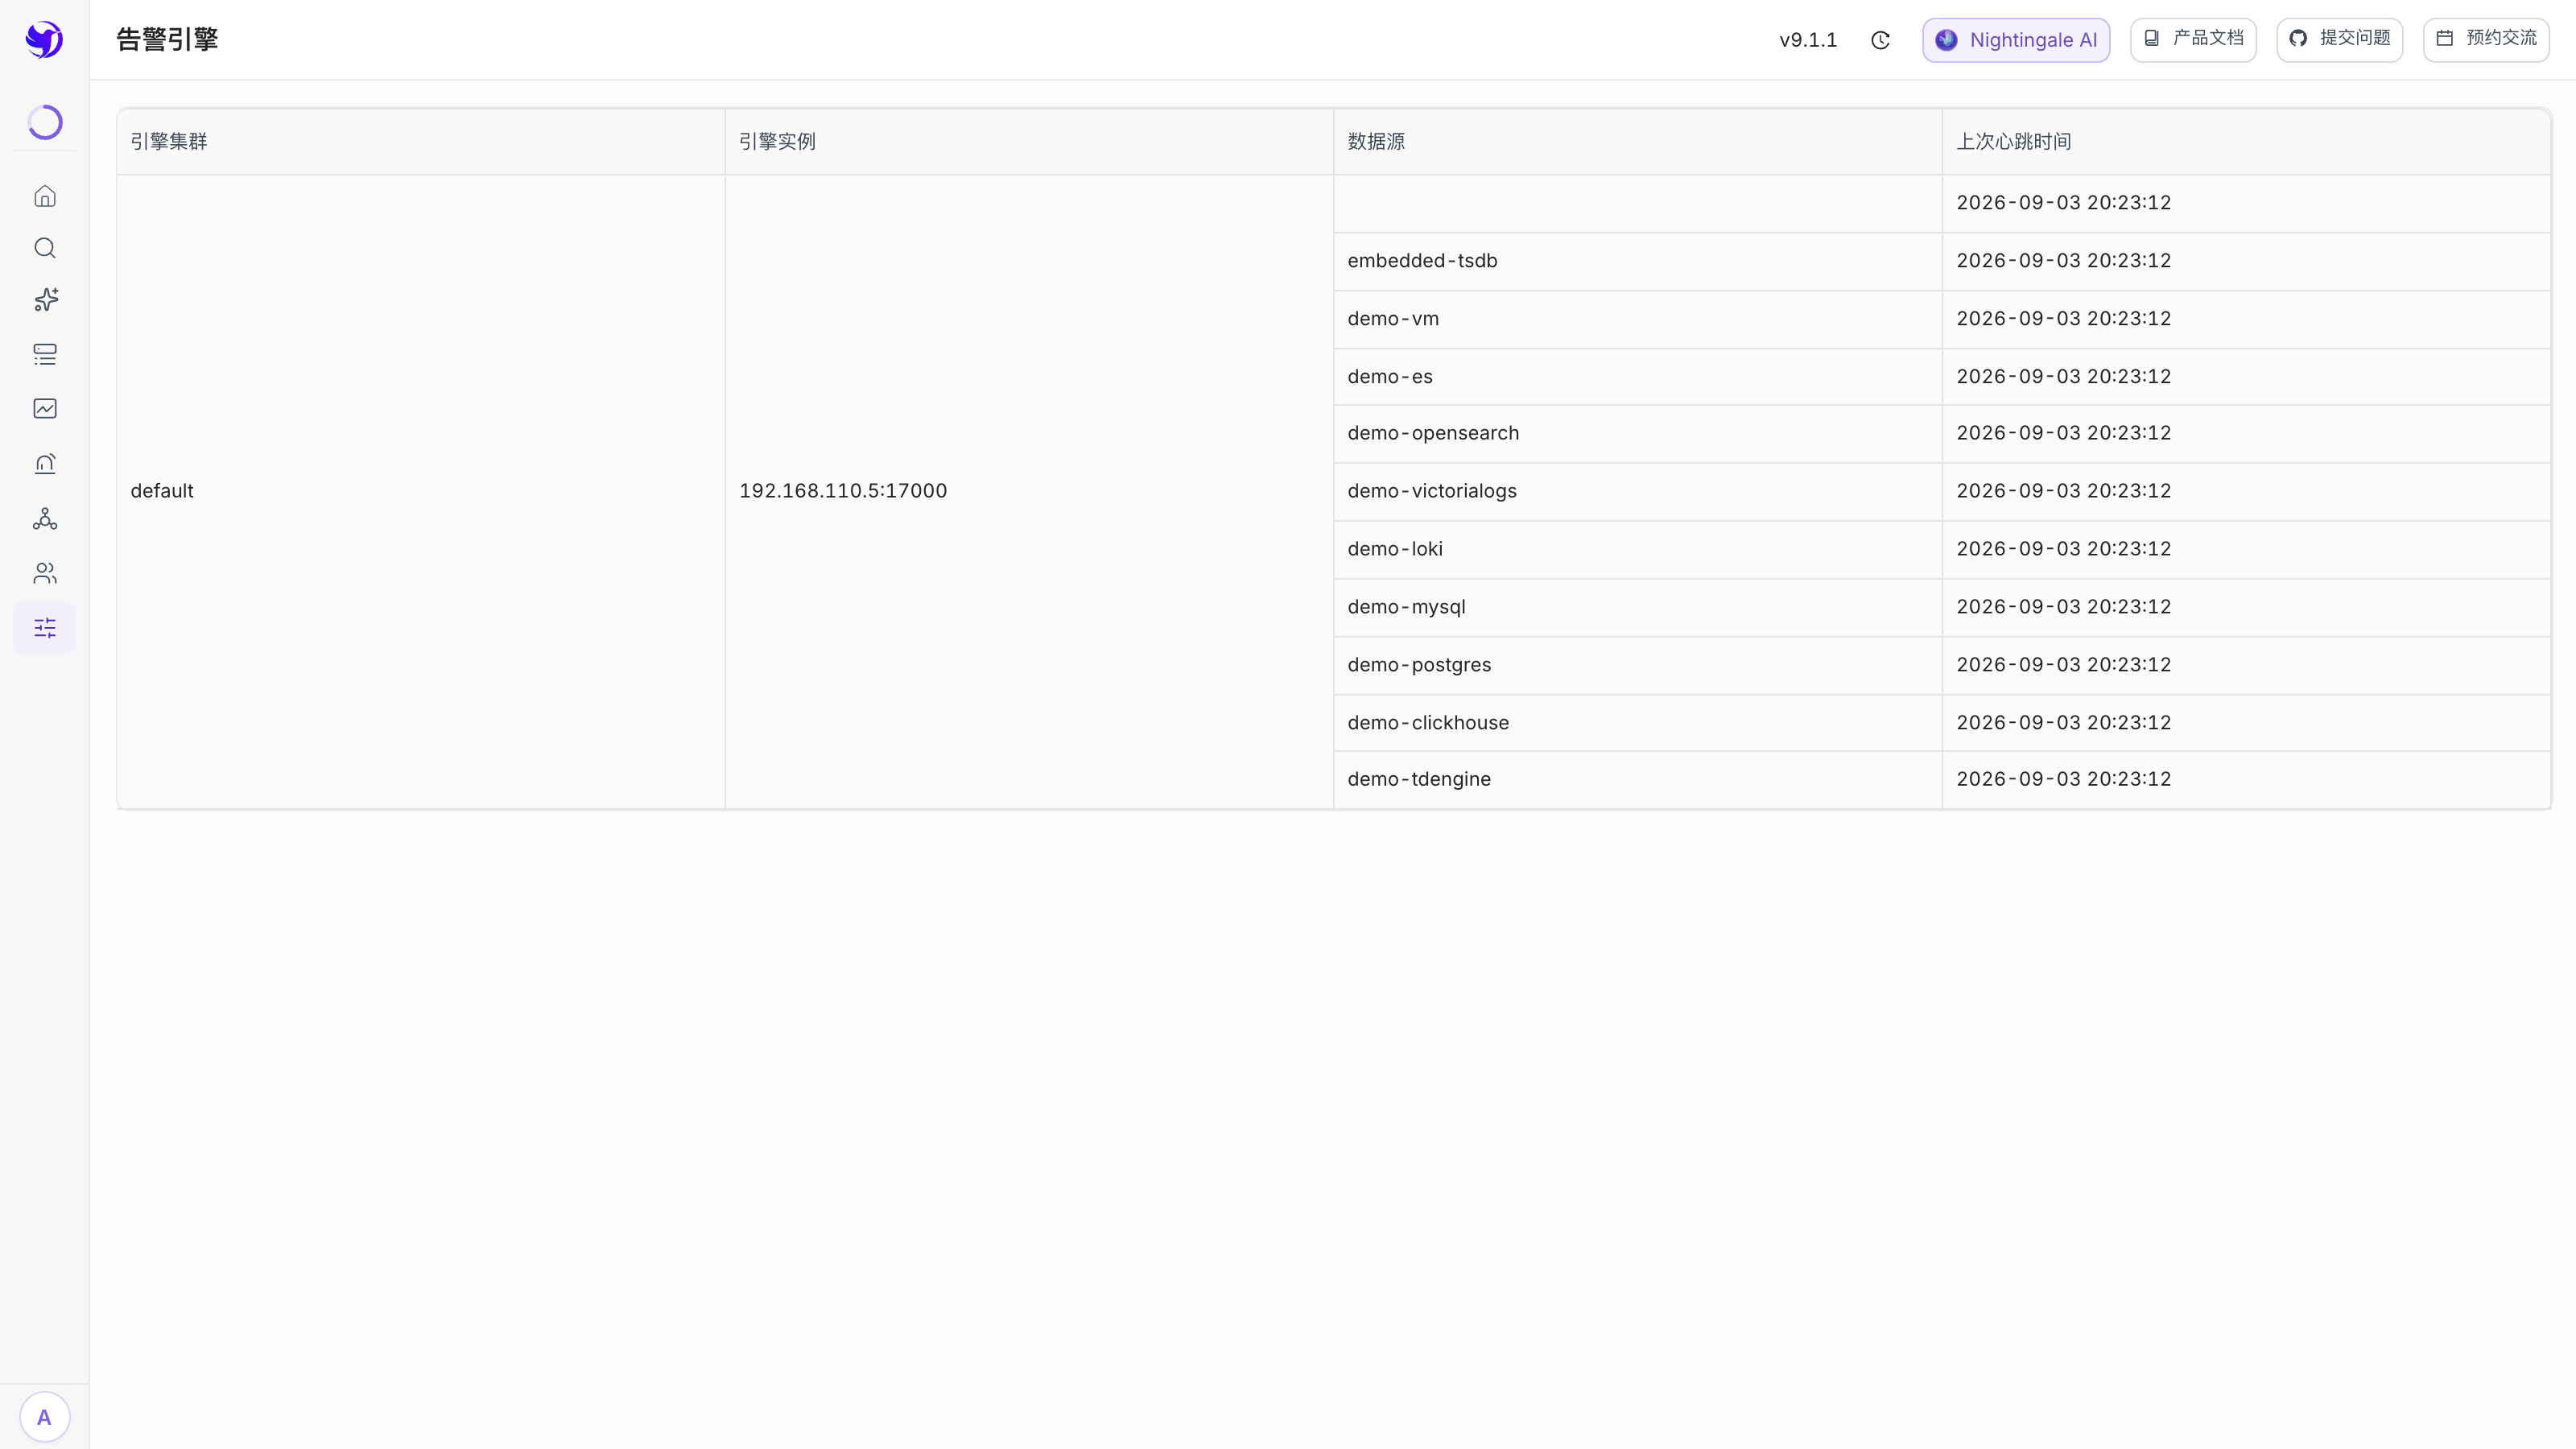
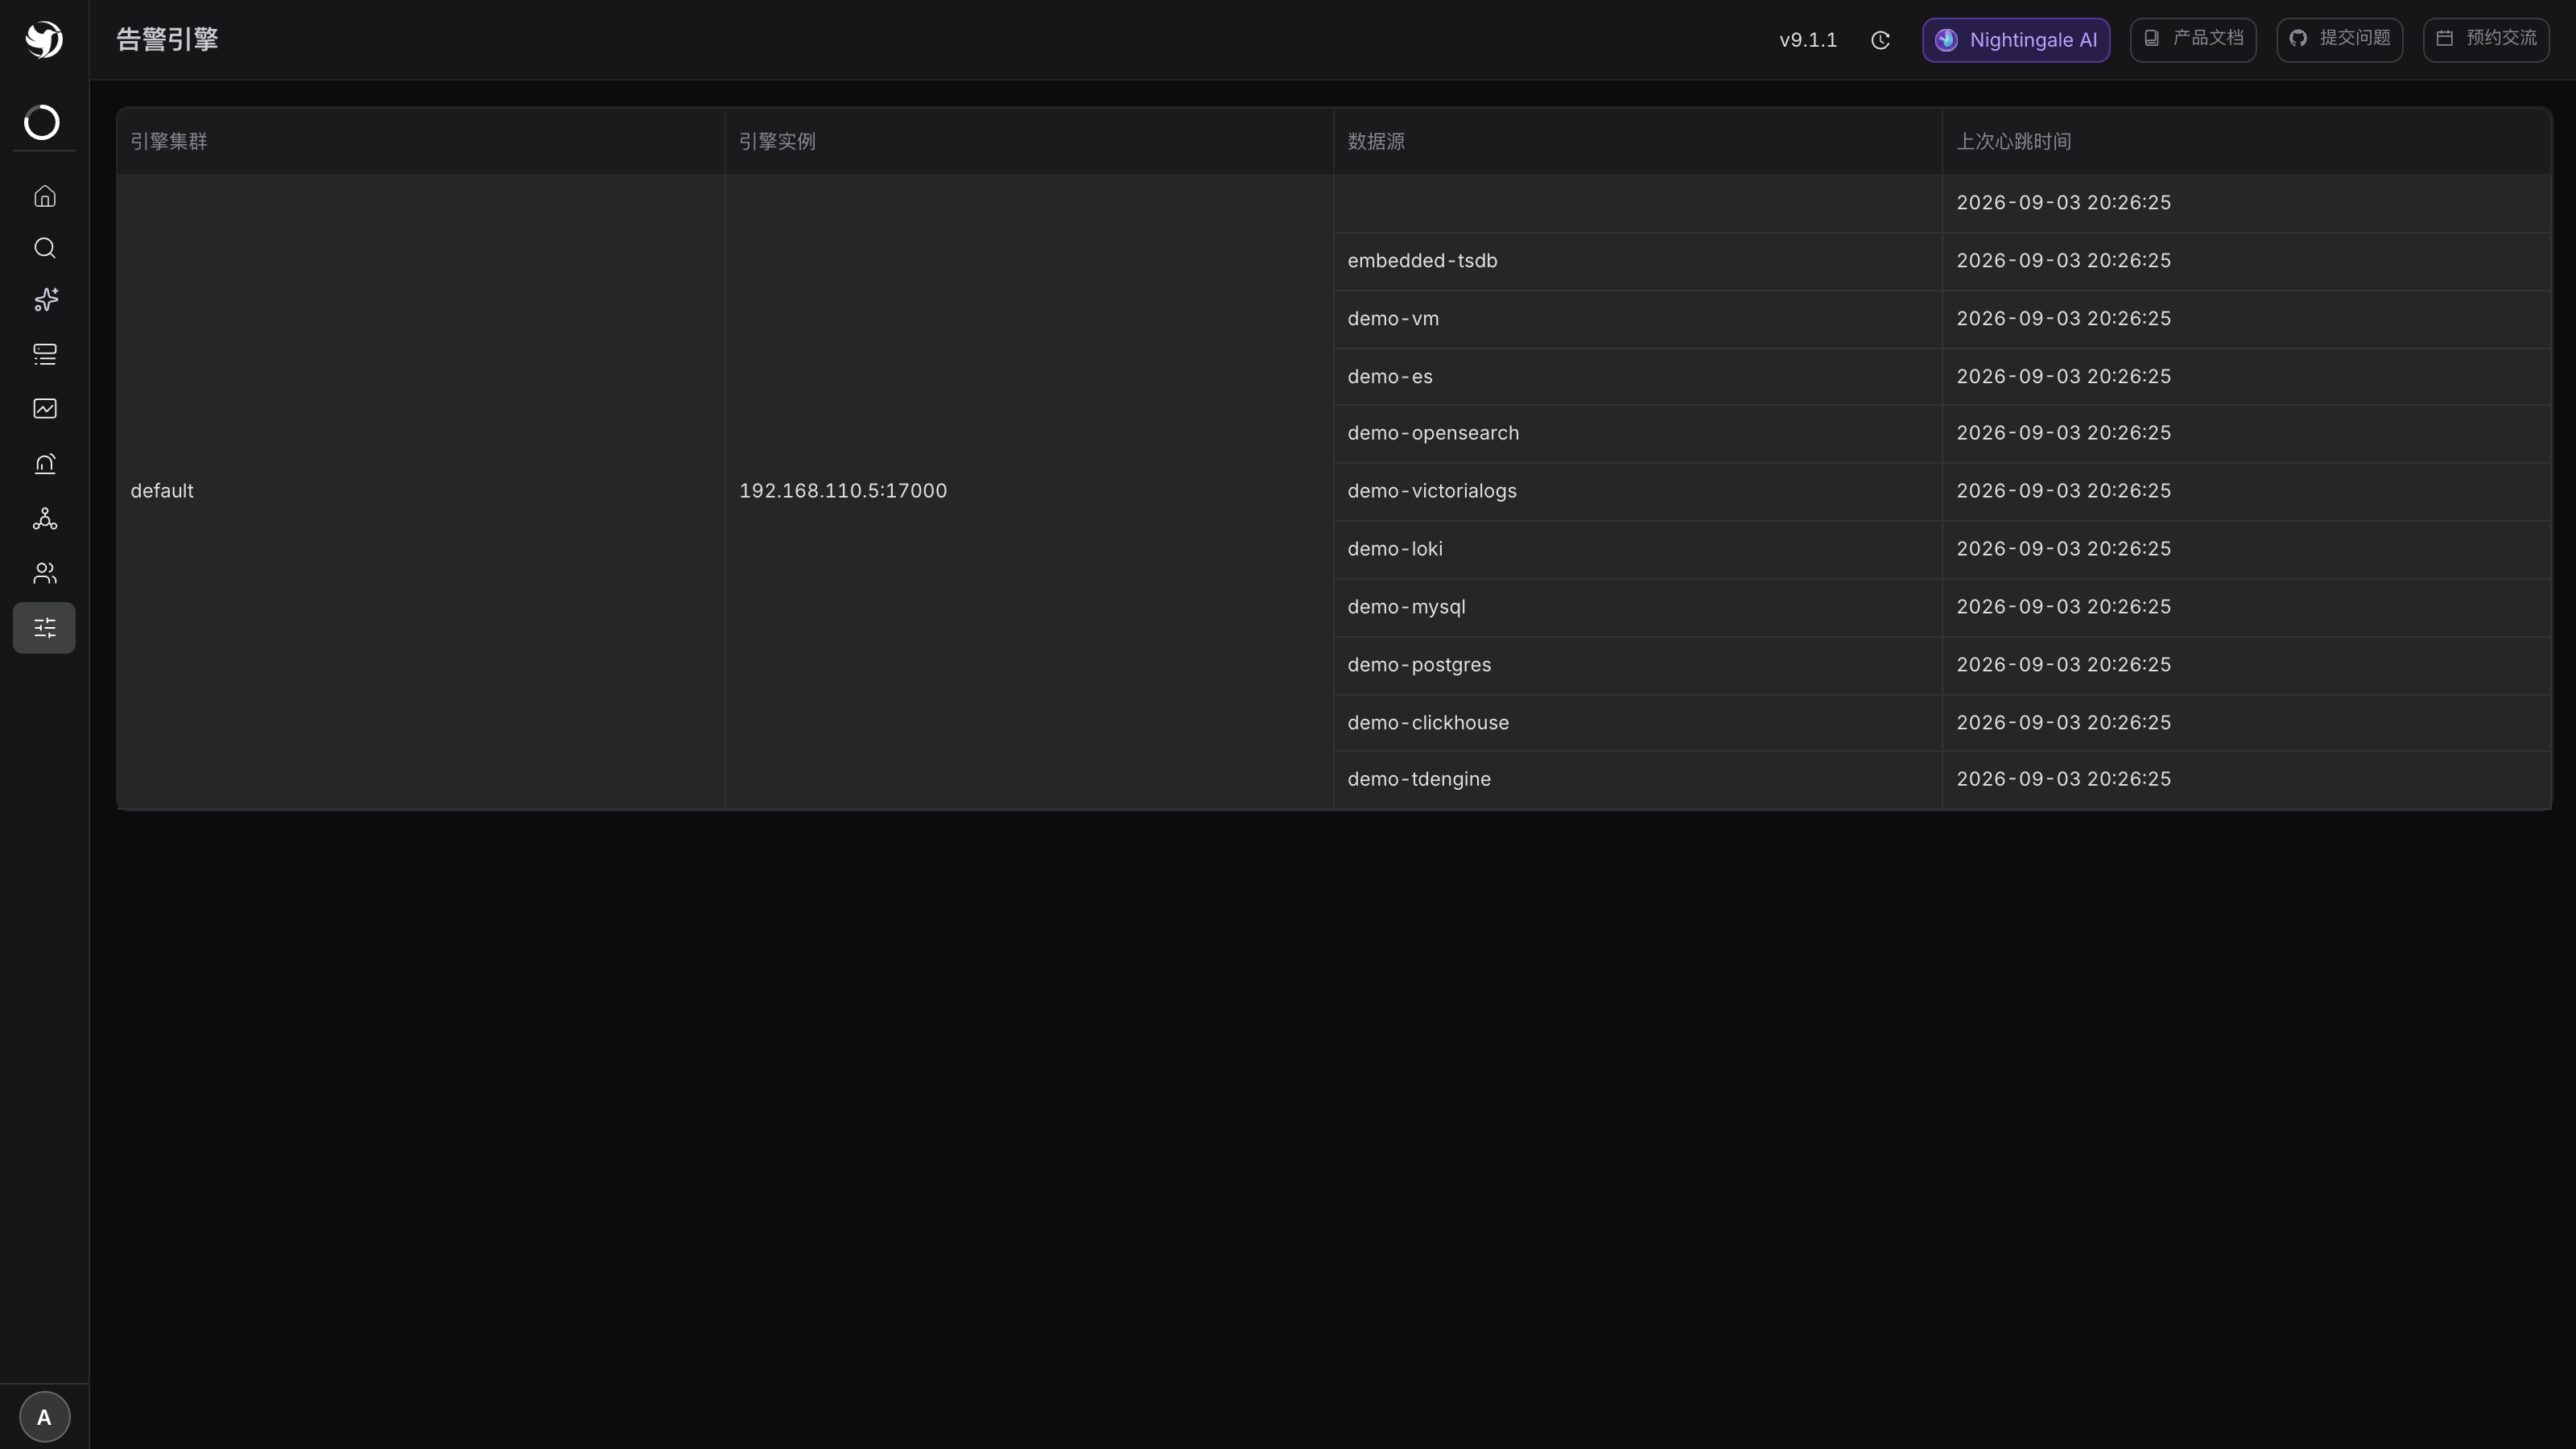
升级里要求一个一个滚,是为了让告警不中断。 迁移竞争是同一条规则的第二个、独立的理由——也是「第一个实例升完要停一停再动第二个」 而不是「隔固定时间动下一个」的原因。
升级窗口里到底损失了什么
以单个实例为单位,从 systemctl stop 到恢复稳态:
| 功能 | 这个实例重启期间 |
|---|---|
| 规则判定 | 它的规则 30 秒内被其他实例接管,之后照常跑 |
| 规则判定(重启的这个实例上) | 启动后还要再等 30 秒才开始([Alert] EngineDelay) |
| 指标写入 | 写到这个实例 /prometheus/v1/write 的请求会失败;前面挂负载均衡,或者接受这段缺口 |
| 界面和 API | 只有这个实例上不可用 |
| 通知 | 跟着判定走——谁判定谁发 |
| 内置时序库 | 整个重启期间既读不了也写不了,何况集群里本来就不该开它 |
| 边缘机房 | n9e-edge 继续在本地判定和发通知,见边缘断网行为 |
所有实例一起重启,会把上面第一行变成「升级多久,就多久没有任何规则在判定」—— 这正是要滚动升级的全部理由。
相关
- 升级——具体命令
- v8 升级 v9——跨大版本的破坏性变更
- 高可用与故障域——规则在实例之间怎么流转
- 回滚与恢复——升级不顺利的时候
- 升级或数据库迁移失败——日志里真有东西的时候