记录规则
按计划预先计算开销大的表达式,改为对结果告警。
这页办完你会得到:一条按固定频率预算的记录规则,把一个跑起来要好几秒的 PromQL 变成一个新指标;告警规则和面板改查这个新指标,判定从秒级降到毫秒级。
什么时候值得做
三种情况下值得:
- 同一个昂贵的查询被多条告警规则、多个面板反复用;
- 单次查询本身就要好几秒(多维 join、高基数
sum、histogram_quantile); - 查询带长 range(
[1h]、[1d]),而告警每 30 秒就要回算一遍。
反过来,查询本来就快、又只有一处在用,加一层记录规则只是多一份要维护的东西。
开始之前:数据源要能写回
这是最容易卡住的一步。规则算完之后,结果写回被查询的那个数据源,走的是数据源上 配的 Remote Write URL。这个字段空着,规则会照常执行,但结果无处落地。
集成中心 → 数据源,编辑你要用的 Prometheus 数据源,在「其他」区填 Remote Write URL(表单提示里就列着各家的写法):
Prometheus                    http://localhost:9090/api/v1/write
Thanos                        http://localhost:19192/
VictoriaMetrics 单机版        http://localhost:8428/api/v1/write
VictoriaMetrics 集群版        http://{vminsert}:8480/insert/0/prometheus/api/v1/write
Prometheus 要额外带上 --web.enable-remote-write-receiver 启动才收 remote write。
自动注册的 embedded-tsdb 数据源默认不带这个字段,要自己补:
http://127.0.0.1:17000/prometheus/api/v1/write
内置时序库的 /prometheus 端点默认只接受本机请求,而记录规则是 Center 进程里的
告警引擎在跑,所以填 127.0.0.1 就够。
1. 建一条记录规则
数据查询 → 指标 → 记录规则(/recording-rules),点 新增。
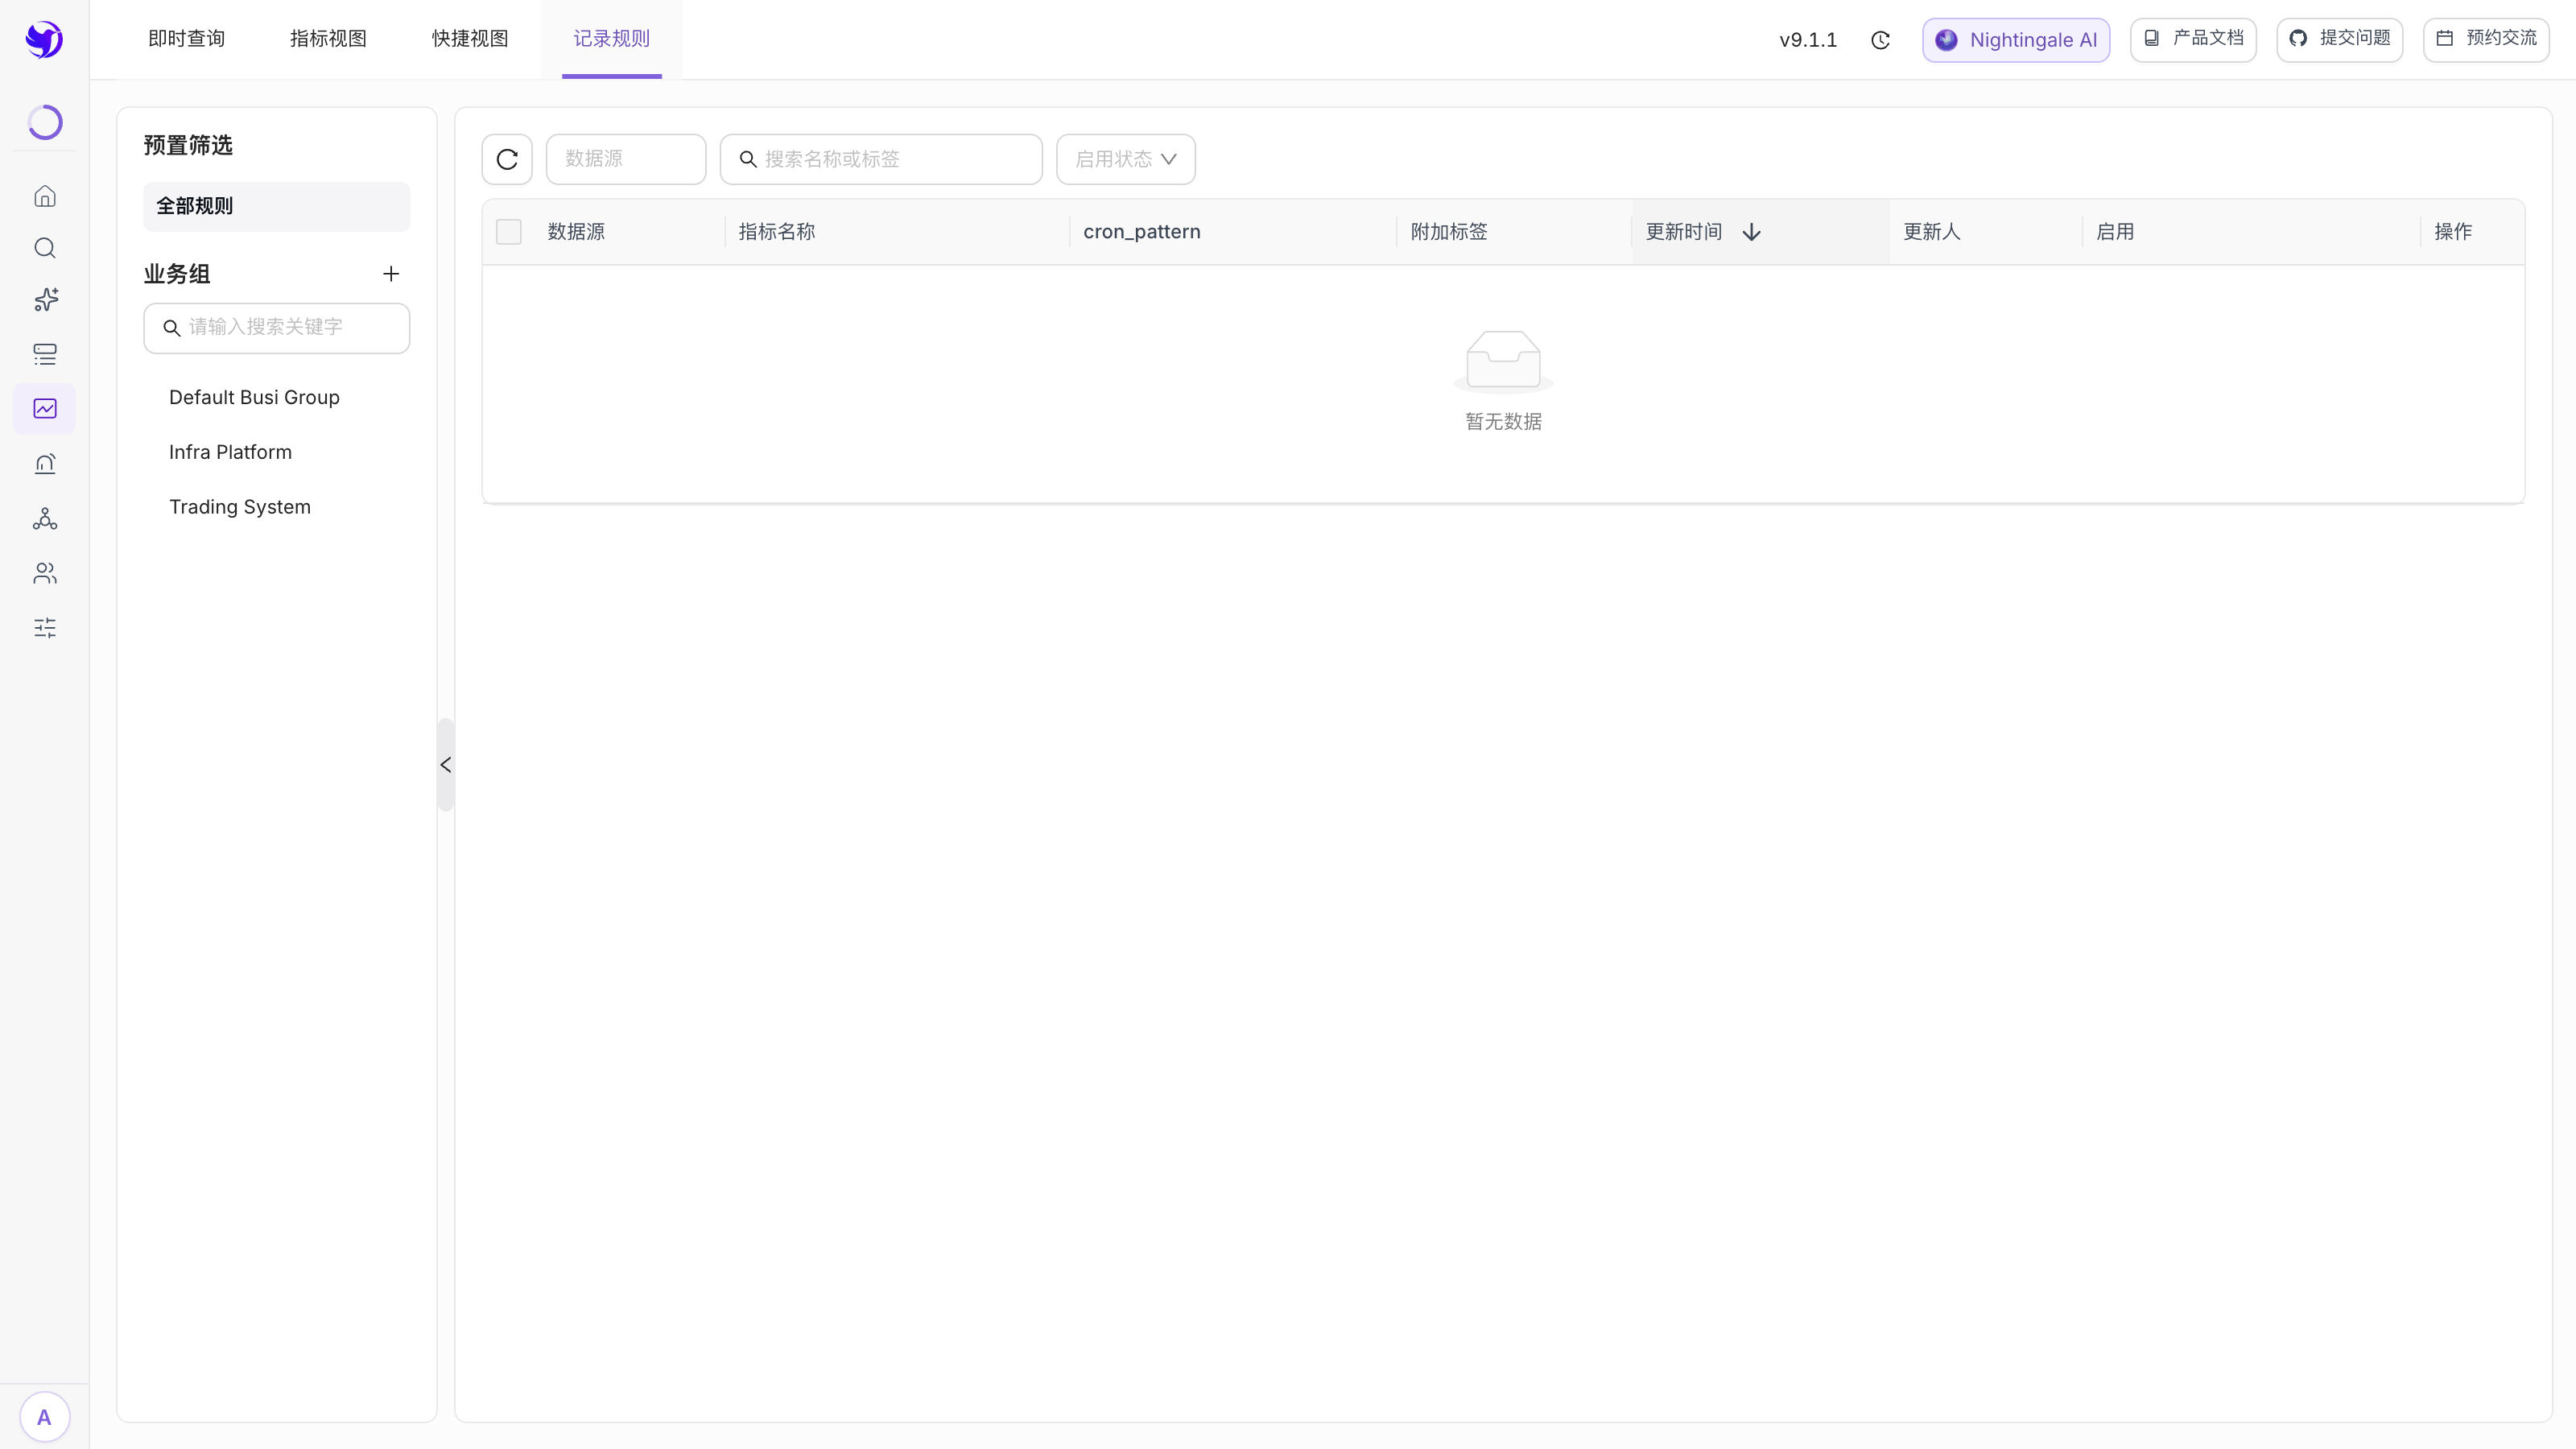
| 字段 | 填什么 |
|---|---|
| 业务组 | 规则归属哪个业务组,决定谁能改它 |
| 指标名称 | 产出的新指标名。按 Prometheus 约定写成 <level>:<metric>:<operations> |
| 备注 | 一句话说清这条规则给谁用 |
| 数据源 | 只能选 Prometheus 类型,可多选。选几个就在几个数据源上各跑一份,各写回各自的 Remote Write URL |
| PromQL | 要预算的表达式,不带阈值。每个周期执行的是一次即时查询,表达式必须返回瞬时向量 |
| 执行频率 | 精确到秒的 cron 表达式,默认 @every 15s,下拉里备好了 15s 到 300s |
| 附加标签 | key=value,回车或空格分隔,会写进新指标的标签里 |
一个典型的填法:
指标名称    service:http_latency:p99_5m
PromQL      histogram_quantile(0.99, sum by (service, le) (rate(http_duration_seconds_bucket[5m])))
执行频率    @every 30s
保存。预期结果:列表里出现这条规则,「启用」开关是打开的。
2. 确认新指标真的写进去了
等一到两个执行周期,去 数据查询 → 指标,选同一个数据源,查新指标名:
service:http_latency:p99_5m
有数据点出来就成了。查不到,按这个顺序排:
- 列表里这条规则的「启用」开着吗;
- 数据源的 Remote Write URL 填了吗(上面那节);
- 把 PromQL 原样粘到即时查询里跑一遍——原查询本身查不出东西,记录规则自然 也写不出东西;
- 看 n9e 日志里的
record_eval:行,查询失败记query error,写入失败记write error。
3. 把告警规则改成查新指标
原来的规则查的是:
histogram_quantile(0.99, sum by (service, le) (rate(http_duration_seconds_bucket[5m]))) > 1
改成:
service:http_latency:p99_5m > 1
阈值不变,判定的开销从「每次重算一遍分位数」变成「读一个轻量指标」。
降基数才有意义
记录规则的收益来自输出比输入小得多。做错了反而更慢——把「查询慢」换成 「写入慢 + 查询稍快」。
- 用
sum by (维度子集)把标签收敛到真正要用的那几个; - 别保留
instance、pod这类会不断变的标签,除非告警真的按它分组; - 输出的序列数应该比输入少一到两个数量级;
- 执行频率不要比原始指标的采集频率还短——采集 15 秒一个点,规则 5 秒跑一次 只是重复读同一批点。
它不做的事
- 不回填历史。 新指标从启用那一刻开始产出,之前的时间区间里没有它。要看历史 只能回去查原始表达式。
- 一条规则一条 PromQL。 表单里只有一个 PromQL 输入框,没有多查询合成、 跨数据源计算、指定回写目标这些。
- 不能写到别的库。 结果固定写回被查询的那个数据源,靠它自己的 Remote Write URL 决定落到哪里。